
DirectX se está convirtiendo en una plataforma de ML: qué significan el álgebra lineal y los sombreadores neuronales para los futuros juegos
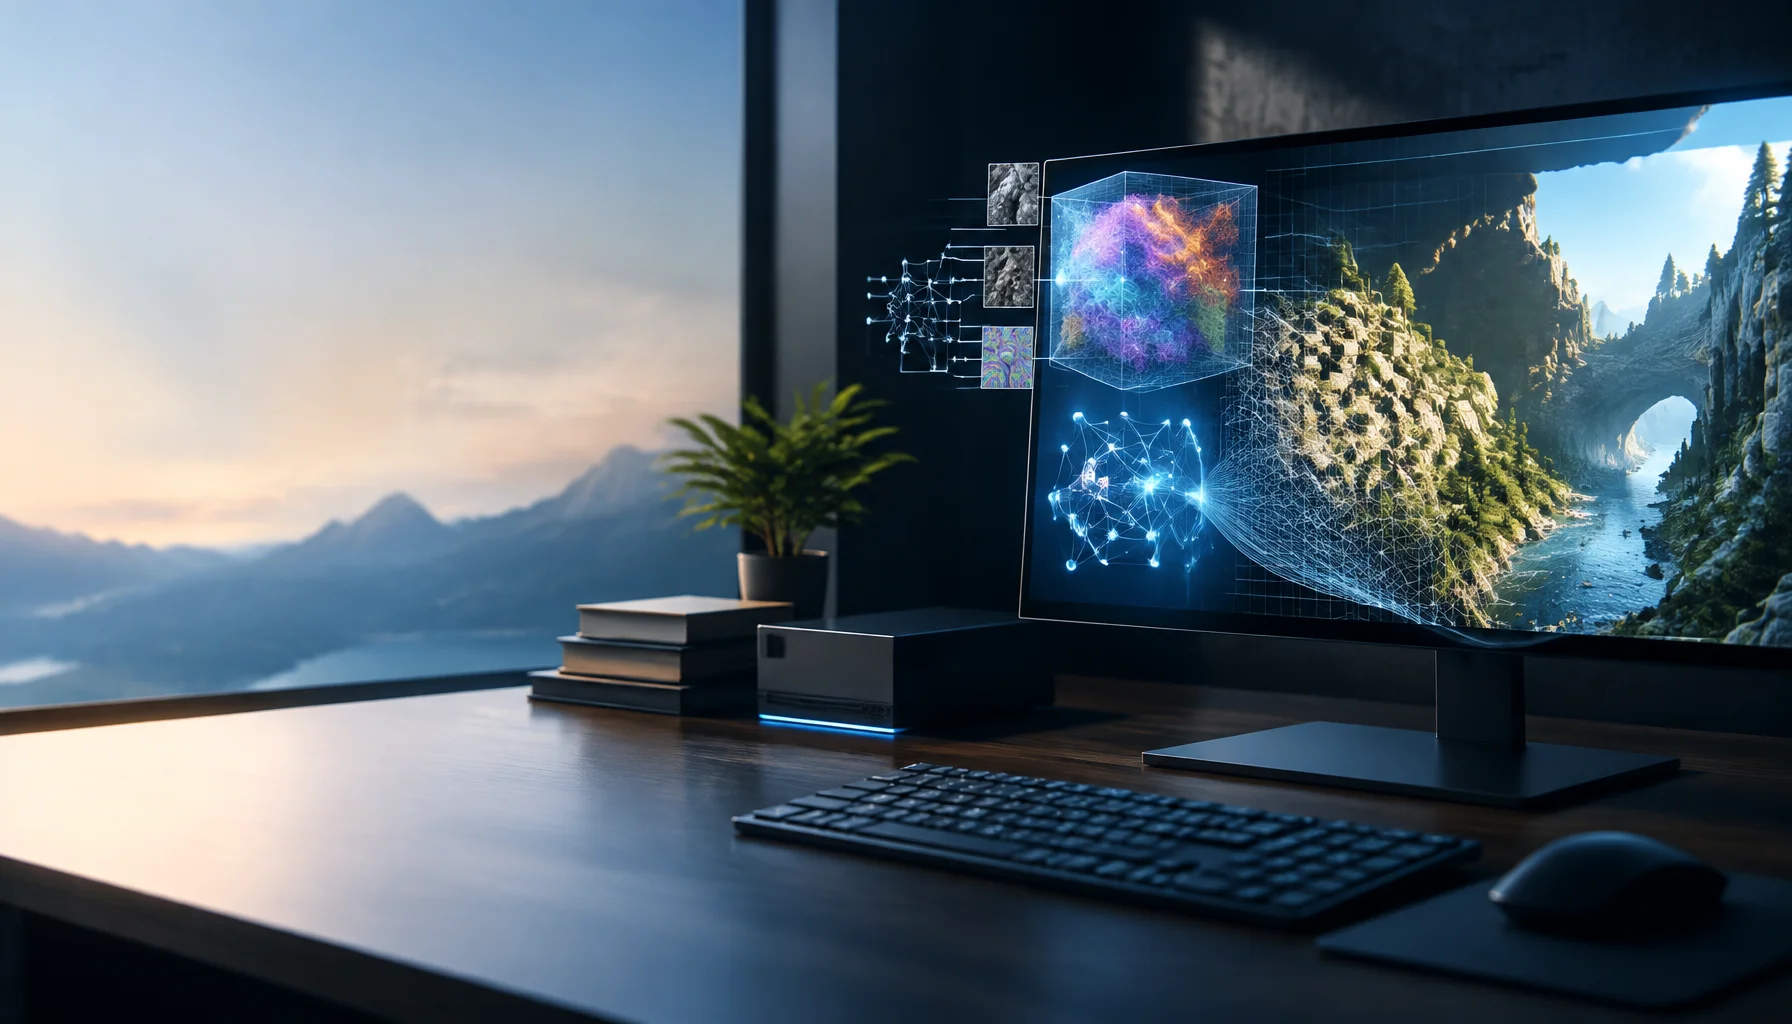
DirectX ya no es solo una API de gráficos que envía sombreadores tradicionales a la GPU. Microsoft está agregando primitivas de aprendizaje automático directamente a HLSL y una segunda ruta para ejecutar grafos de ML más grandes dentro del ecosistema de DirectX. Eso cambia dónde puede vivir la representación neuronal dentro de los futuros juegos de PC.
Por qué la representación neuronal necesita nuevas primitivas de DirectX
Las GPU modernas ya contienen hardware especializado para operaciones matriciales utilizadas por el aprendizaje automático. El problema para un desarrollador de juegos no es solo si ese hardware existe, sino cómo acceder a él de manera eficiente desde una canalización de gráficos en tiempo real.
Microsoft exploró esto por primera vez con el soporte de Cooperative Vector. En 2026, ese trabajo evolucionó hacia un diseño más amplio de DirectX Linear Algebra que admite operaciones de vector-matriz y matriz-matriz.
Eso importa porque diferentes trabajos de representación neuronal tienen diferentes formas. Un modelo pequeño que evalúa el comportamiento del material por píxel no es la misma carga de trabajo que un grafo grande de superresolución o eliminación de ruido.
El modelo de ML de DirectX de dos niveles
Dos formas en que el ML puede entrar en la canalización de gráficos de DirectX
Qué le da realmente DX Linear Algebra a un sombreador
El HLSL tradicional está construido en torno a operaciones de gráficos y cómputo. Las cargas de trabajo neuronales dependen en gran medida del álgebra lineal: vectores, matrices, multiplicación, acumulación y diseños de datos optimizados para esas operaciones.
La vista previa de Shader Model 6.10 agrega API de matrices de primera clase para que los desarrolladores puedan expresar esas cargas de trabajo de manera más directa y permitir que el controlador las asigne a hardware especializado.
La vista previa de Microsoft de abril de 2026 describe explícitamente esto como una ruta unificada para la representación neuronal, el ML y las cargas de trabajo de procesamiento de imágenes en lugar de una característica solo para gráficos.
Matemáticas de sombreador tradicionales vs matemáticas de sombreador orientadas a ML
| Enfoque de sombreador tradicional | Enfoque orientado a ML | |
|---|---|---|
| Trabajo típico | ||
| Ruta de hardware | ||
| Expresión del desarrollador |
Por qué Cooperative Vector fue solo el comienzo
Cooperative Vector permitía a los hilos de sombreador solicitar trabajo de vector-matriz que los controladores podían asignar a hardware especializado. Eso era útil para cargas de trabajo altamente paralelas por píxel.
Microsoft concluyó más tarde que muchas cargas de trabajo importantes de ML necesitan más que operaciones de vector-matriz. La superresolución, la eliminación de ruido, la reconstrucción temporal, los modelos de imagen más grandes y la inferencia general pueden requerir operaciones de matriz-matriz y trabajo compartido entre muchos hilos.
Por lo tanto, DX Linear Algebra amplía el modelo en lugar de tratar Cooperative Vector como la abstracción final.
¿Qué puede ejecutarse realmente dentro de un shader?
Las cargas de trabajo de ML a nivel de shader más interesantes son lo suficientemente pequeñas como para ejecutarse cerca de los datos gráficos sobre los que operan.
| Carga de trabajo | Por qué el ML a nivel de shader encaja |
|---|---|
| Compresión de texturas neuronales | Una red pequeña puede reconstruir información de textura cerca del punto donde el shader la necesita |
| Evaluación de materiales neuronales | Una función aprendida puede reemplazar o aumentar cálculos de materiales costosos escritos a mano |
| Caché de radiancia neuronal | La inferencia por píxel o local puede estimar información de iluminación a partir del comportamiento aprendido de la escena |
| Pequeños kernels de eliminación de ruido/reconstrucción | Las operaciones de ML pueden situarse directamente junto a la etapa de renderizado que mejoran |
| Inferencia de procesamiento de imágenes | Las operaciones matriciales pueden integrarse en el procesamiento de GPU sin un runtime externo separado |
Por qué esto importa para la memoria de texturas
Uno de los ejemplos recurrentes de Microsoft es la compresión de texturas neuronales.
En lugar de almacenar cada canal de textura con fidelidad convencional, un juego puede almacenar una representación más compacta y usar una pequeña red neuronal para reconstruir el detalle durante el renderizado.
Eso intercambia algo de trabajo de inferencia en la GPU por menor almacenamiento o presión de memoria. El beneficio exacto depende de la técnica y el hardware, pero el cambio arquitectónico es importante: parte del detalle visual puede convertirse en cómputo en lugar de datos almacenados.
Por qué los modelos completos necesitan un camino diferente
Escribir a mano unas pocas operaciones matriciales en HLSL es práctico para funciones neuronales pequeñas. Se vuelve mucho menos práctico cuando la carga de trabajo es un modelo moderno completo con muchas capas, dependencias y tensores intermedios.
El DirectX Compute Graph Compiler de Microsoft está diseñado para esta clase más amplia de cargas de trabajo.
En lugar de reescribir el modelo como código de shader personalizado, el compilador puede aceptar un grafo de cómputo, analizar todo el grafo, planificar la memoria, fusionar operaciones y reducir el resultado a trabajo de GPU que se integra con DirectX 12.
La frontera entre shader o grafo
Cuándo la carga de trabajo de ML pertenece a HLSL frente a un compilador de modelos
| Ruta a nivel de shader | Ruta a nivel de modelo | |
|---|---|---|
| Tamaño del modelo | ||
| Estilo de ejecución | ||
| Autoría | ||
| Alcance de la optimización | ||
| Uso típico |
Por qué el soporte entre proveedores importa más que otra función de IA
AMD, Intel, NVIDIA y Qualcomm exponen diferentes arquitecturas de GPU y diferentes formas de aceleración matricial dedicada.
Una abstracción de DirectX ofrece a Microsoft y a los proveedores de controladores un lugar para traducir HLSL común o ML a nivel de grafo en la ruta de hardware correcta.
Eso no hace que todas las GPU sean igual de rápidas, pero puede reducir la necesidad de que un motor de juego implemente una API de renderizado neuronal completamente diferente para cada proveedor.
¿Qué hardware admite la vista previa actual?
La respuesta depende de la operación específica de álgebra lineal y del controlador de vista previa.
La tabla de compatibilidad de la vista previa del Agility SDK 1.721 de Microsoft incluye LinAlg VectorAccumulate para hardware AMD Radeon RX Serie 9000, hardware Intel Xe2 o más reciente mediante un controlador próximo, y hardware NVIDIA RTX mediante la ruta de vista previa compatible.
Esto es compatibilidad de la era de vista previa, no una garantía universal de venta al público. La compatibilidad de hardware y controladores puede cambiar antes de la finalización.
El renderizado neuronal se está convirtiendo en infraestructura
DLSS, FSR y otras tecnologías de gráficos neuronales suelen discutirse como características de marca visibles en el menú de configuración de un juego.
DirectX Linear Algebra apunta a un cambio más profundo. La operación neuronal puede convertirse en un detalle de implementación interno dentro del renderizador en lugar de una única característica opcional de posprocesamiento.
Un desarrollador podría usar ML para texturas, materiales, iluminación, reconstrucción u otras funciones locales sin exponer cada una como un interruptor de IA orientado al consumidor.
La pila de renderizado neuronal se está volviendo por capas
Una posible futura canalización de juego con DirectX
Por qué importa la creación de perfiles unificada
Una carga de trabajo neuronal que mejora la calidad de imagen aún puede dañar un juego si consume inesperadamente tiempo de fotograma, ancho de banda de memoria o VRAM.
Microsoft incluye explícitamente la visibilidad unificada de PIX como parte de la dirección del Compute Graph Compiler. Eso importa porque los desarrolladores necesitan ver el trabajo de gráficos y ML en la misma captura de fotograma.
Si el renderizado neuronal se convierte en infraestructura, debe ser medible como cualquier otra etapa de renderizado.
Esto no significa que todos los shaders se convertirán en redes neuronales
Las matemáticas tradicionales de los shaders siguen siendo eficientes, deterministas y fáciles de razonar para muchas cargas de trabajo.
Una función neuronal tiene sentido cuando puede aproximar o reconstruir algo costoso de manera más eficiente, comprimir datos o producir una calidad que de otro modo requeriría demasiado cómputo o memoria convencionales.
La arquitectura correcta seguirá siendo híbrida.
La prueba de valor del shader neuronal
¿Cuándo tiene realmente sentido incorporar ML en la canalización de renderizado?
Qué significa esto para los jugadores
Es posible que los jugadores nunca vean un interruptor de “DX Linear Algebra” en un menú de gráficos.
El impacto probable es indirecto: texturas más pequeñas, mejor reconstrucción de iluminación, gráficos neuronales más eficientes o nuevas técnicas visuales que se vuelven prácticas porque el motor puede acceder a la aceleración de matrices a través de una ruta estándar.
La característica es más importante como infraestructura que como marca.
¿Qué cambiaría esta respuesta?
La mayor incertidumbre es la forma final de venta al público de estas API. DX Linear Algebra sigue en vista previa, y el Compute Graph Compiler aún no ha alcanzado una disponibilidad amplia para el público.
El soporte final de hardware, los detalles de la API, el comportamiento del compilador y la adopción por parte de los motores pueden cambiar antes de que estos sistemas se conviertan en infraestructura normal para juegos comerciales.
Si los motores principales adoptan las abstracciones directamente, los shaders neuronales podrían volverse mucho más comunes sin que los equipos individuales de juegos implementen cada técnica desde cero.
Limitaciones
Este artículo explica la arquitectura DirectX documentada por Microsoft y las API en vista previa. No afirma que DX Linear Algebra mejore actualmente el rendimiento en todos los juegos ni que el Compute Graph Compiler sea un producto final para el público.
Los ejemplos de Microsoft describen capacidades y el uso previsto. Los beneficios reales dependen del modelo, la integración con el motor, la arquitectura de la GPU, los controladores y la carga de trabajo.
Conclusión
El cambio importante de DirectX no es otra casilla de verificación llamada IA.
Es que las matemáticas de aprendizaje automático se están trasladando al propio modelo de programación de gráficos. Las funciones neuronales pequeñas pueden residir dentro de los sombreadores, los modelos más grandes pueden avanzar hacia la compilación a nivel de grafo, y la misma cadena de herramientas de DirectX puede exponer esas cargas de trabajo en múltiples proveedores de GPU.
Así es como la representación neuronal deja de ser una característica de marca y comienza a formar parte de la infraestructura de representación.
Preguntas frecuentes
Álgebra lineal de DirectX y sombreadores neuronales
¿Qué es el Álgebra lineal de DirectX?
¿Qué es un sombreador neuronal?
¿Es el Álgebra lineal de DX ya una característica normal de DirectX para el consumidor?
¿Qué es el Compilador de grafos de cómputo de DirectX?
¿Por qué no ejecutar todos los modelos de aprendizaje automático directamente en HLSL?
¿Reemplazará esto a DLSS o FSR?
Glosario
Términos clave de aprendizaje automático de DirectX
- Álgebra lineal de DX
- API de DirectX/HLSL para operaciones vectoriales y matriciales aceleradas destinadas a cargas de trabajo de representación neuronal, aprendizaje automático y procesamiento de imágenes.
- Vector cooperativo
- Un enfoque anterior de DirectX para operaciones vector-matriz aceleradas dentro de sombreadores que ayudó a establecer la ruta de representación neuronal a nivel de sombreador.
- Shader Model 6.10
- La generación de modelo de sombreador en vista previa que contiene las API de matriz de Álgebra lineal de DirectX actuales.
- Compilador de grafos de cómputo de DirectX
- La API de compilador anunciada por Microsoft para optimizar y ejecutar grafos de cómputo de aprendizaje automático más grandes como cargas de trabajo nativas de GPU de DirectX.
- Sombreador neuronal
- Un término práctico para un sombreador que realiza inferencia aprendida o computación neuronal como parte del procesamiento gráfico.
- Frontera sombreador-o-grafo
- Un modelo de Figure Rocks para decidir si una carga de trabajo de aprendizaje automático pertenece como matemáticas de sombreador en línea pequeñas o como un grafo de cómputo a nivel de modelo más grande.
- Prueba de valor del sombreador neuronal
- Un flujo de trabajo de Figure Rocks para decidir si el costo tradicional de cómputo o memoria evitado por una técnica neuronal vale sus costos de inferencia y compensaciones de calidad.
Fuentes primarias
Microsoft DirectX — Evolucionando DirectX para la era del aprendizaje automático en WindowsDescripción general oficial de la arquitectura de GDC 2026 que cubre aprendizaje automático a nivel de sombreador, Álgebra lineal de DX y el Compilador de grafos de cómputo de DirectX.
Microsoft DirectX — Vista previa de D3D12 LinAlg MatrixVista previa oficial de abril de 2026 que explica las API unificadas de Álgebra lineal, operaciones matriciales y la motivación de representación neuronal.
Microsoft DirectX — Vista previa de Agility SDK 1.721Lanzamiento oficial de mayo de 2026 que documenta las actualizaciones de Álgebra lineal de Shader Model 6.10 y el soporte de hardware en vista previa.
Microsoft Game Dev — GDC 2026: Evolucionando DirectX para la era del aprendizaje automáticoResumen oficial de Microsoft Game Dev que explica el aprendizaje automático a nivel de sombreador y a nivel de modelo y el papel del Compilador de grafos de cómputo.
Microsoft DirectX — Vector cooperativo de D3D12Antecedentes oficiales sobre operaciones vectoriales/matriciales aceleradas por hardware y representación neuronal directamente desde hilos de sombreador.
Related Articles
Ajuste de Overdrive: la forma limpia de reducir el desenfoque sin ghosting
El Overdrive puede mejorar la claridad o añadir halos feos. Usa este método sencillo para elegir el ajuste intermedio limpio que reduce el desenfoque sin artefactos de ghosting.
AMD FSR Redstone no es solo FSR 4: escalado, generación de fotogramas, regeneración de rayos y caché de radiancia explicados
El nombre de FSR de AMD cambió porque FSR ya no es una sola función. Redstone es ahora una suite de renderizado neuronal con tecnologías separadas para el escalado, la generación de fotogramas, la reconstrucción de trazado de rayos y la iluminación global aprendida.
PUBG Ally muestra por qué los compañeros de equipo de IA necesitan dos cerebros: reflejos rápidos y razonamiento lento
Un modelo de lenguaje puede entender tácticas y la intención del jugador, pero no debería controlar directamente cada movimiento y reacción de combate. PUBG Ally muestra una arquitectura más práctica: control rápido mediante árboles de comportamiento para acciones reflejas, combinado con un modelo de lenguaje pequeño para planificación, coordinación y conversación natural.
Claridad de movimiento: Por qué ocurre el desenfoque y las soluciones que realmente funcionan
El desenfoque de movimiento no es solo un ajuste — es sincronización más persistencia. Aprende el orden práctico: modo correcto, frecuencia de actualización correcta, luego los pocos arreglos de claridad que importan.
Más allá del escaneo – Usos creativos y modificaciones de amiibo"
amiibo son figuras de personajes equipadas con NFC lanzadas por Nintendo desde 2014. Técnicamente, son pequeños soportes de datos dentro de figuras de plástico moldeado. En la práctica, se sitúan en algún punto entre juguete, objeto de colección y dispositivo de interfaz. Escanearlos en una consola es solo una parte de su ciclo de vida. Observado a lo largo de los años, muchos propietarios los tratan como objetos con su propio potencial creativo.
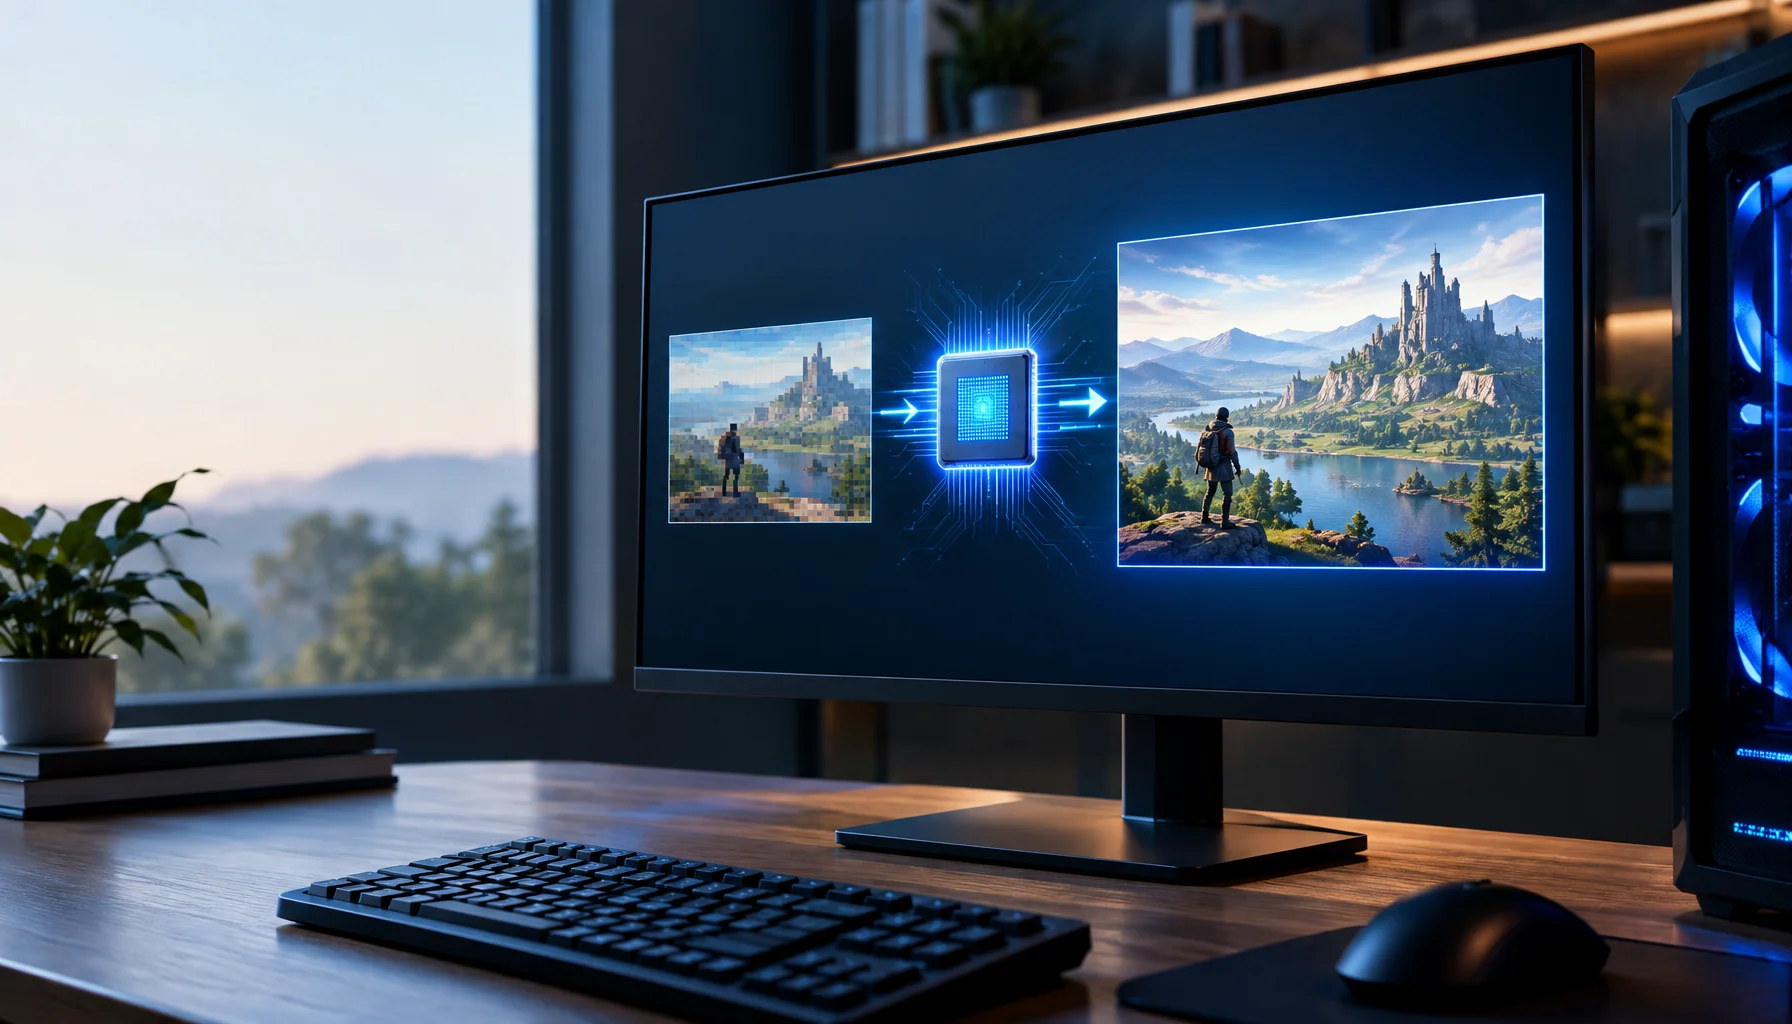
Windows Auto SR no es DLSS: cómo funciona el escalado por NPU sin integración en el juego
Windows Auto SR puede reescalar juegos compatibles sin integración de DLSS, FSR o XeSS. En lugar de ejecutar el modelo de reconstrucción dentro del juego en la GPU, Windows utiliza la NPU para reconstruir una imagen de mayor resolución a partir de un renderizado de menor resolución.
Por qué los juegos de PC se entrecortan al compilar shaders — y cómo la entrega avanzada de shaders lo cambia
El tartamudeo de shaders ocurre cuando un juego de PC tiene que compilar programas de GPU en el momento equivocado. Microsoft Advanced Shader Delivery traslada gran parte de ese trabajo fuera del PC del jugador al preparar shaders específicos para el hardware con antelación y entregarlos junto con el juego.
¿Los 120Hz se sienten peor? Lista de verificación de diagnóstico (Modo incorrecto, rango de VRR, límites)
Una mayor frecuencia de actualización puede exponer la inestabilidad. Usa esta lista de verificación para diagnosticar por qué los 120 Hz se sienten peor: modo incorrecto, ruta de actualización incorrecta, problemas de rango de VRR o falta de límites.