
Renderiza menos, infiere más: ¿Está la IA rompiendo el ciclo tradicional de actualización de hardware para videojuegos?
Durante décadas, el gaming en PC para entusiastas siguió un trato familiar: los juegos pedían más cómputo, las generaciones de GPU entregaban más cómputo, y los jugadores actualizaban cuando la brecha se volvía lo suficientemente grande. Ese bucle nunca funcionó a la perfección, pero la dirección era comprensible. En 2026, el bucle se está volviendo más difícil de leer porque dos cambios están ocurriendo al mismo tiempo: la infraestructura de IA compite agresivamente por silicio y memoria, mientras las técnicas de IA se trasladan directamente a la forma en que los juegos crean fotogramas.
La disparidad de escala ya es visible
Newzoo pronostica el mercado global de videojuegos en $213.9 mil millones para 2026, un aumento del 6.1% interanual. La Semiconductor Industry Association reportó $791.7 mil millones en ventas globales de semiconductores para 2025, un aumento del 25.6%, y proyectó aproximadamente $1 billón para 2026. El negocio de los videojuegos y el de los semiconductores todavía dependen uno del otro, pero sus incentivos se están volviendo menos simétricos: el mismo ecosistema de fabricación avanzada que habilita el gaming premium ahora sirve a compradores de IA y centros de datos con presupuestos de infraestructura mucho mayores. Estas no son categorías de productos directamente comparables; establecen la escala de la economía de cómputo upstream alrededor del gaming.
| Punto de referencia | Valor reportado o pronosticado | Por qué importa aquí |
|---|---|---|
| Mercado global de videojuegos, pronóstico 2026 | $213.9B, +6.1% interanual | Gran mercado de entretenimiento de consumo, pero downstream del suministro de hardware avanzado |
| Juegos de PC, pronóstico 2026 | $45.9B, +5.3% interanual | El segmento de gaming más directamente expuesto a la economía de componentes de PC |
| Ventas globales de semiconductores, 2025 | $791.7B, +25.6% interanual | Muestra la escala de la industria upstream que sirve a gaming, IA, móvil, automotriz y nube |
| Industria global de semiconductores, proyección 2026 | ~$1T | Eleva el costo de oportunidad de dedicar silicio premium solo al gaming de consumo |
La memoria es donde la presión se vuelve concreta
TrendForce ha reportado repetidamente que los proveedores de DRAM están desplazando capacidad hacia productos para servidores y HBM a medida que crece la demanda de IA. En marzo de 2026 pronosticó que los precios de contrato de DRAM convencional subirían 58–63% trimestre a trimestre en el Q2 y dijo que la asignación limitada de GDDR estaba restringiendo el suministro de memoria gráfica. Para el Q3, TrendForce dijo que los clientes de consumo estaban alcanzando un límite de asequibilidad incluso mientras la demanda de IA y servidores seguía fuerte.
La presión de asignación de recursos
Exactamente al mismo tiempo, el fotograma mismo está cambiando
Microsoft ahora describe el aprendizaje automático como algo que se está volviendo fundamental para los gráficos en tiempo real. DirectX está agregando rutas de ML a nivel de shader y de modelo para que la compresión neuronal de texturas, el denoising, la superresolución y otras cargas de trabajo aprendidas puedan ubicarse dentro de la pila gráfica en lugar de añadirse como características aisladas. La investigación de DLSS 5 de NVIDIA lleva la idea más lejos al introducir una etapa de renderizado neuronal generativo que complementa el renderizado convencional con priors de apariencia aprendidos. El renderizado neuronal no significa que el renderizado convencional desaparezca. El modelo emergente es híbrido: renderizar alguna información directamente, inferir o reconstruir otra información cuando hacerlo es más barato o más útil.
Escalado tradicional vs escalado de la era neuronal
| Ruta tradicional | Ruta de la era neuronal | |
|---|---|---|
| Más fidelidad visual | Almacenar más detalle y renderizar más trabajo | Almacenar/renderizar selectivamente, reconstruir o inferir algunos detalles |
| Respuesta de memoria | Agregar capacidad y ancho de banda | Agregar capacidad donde se necesite, pero también comprimir y reducir el movimiento |
| Respuesta de rendimiento | Más throughput de shader/RT | Mezclar cómputo de shader, RT y estilo matriz/Tensor |
| Rol del software | El motor programa principalmente trabajo gráfico convencional | El motor programa cada vez más el renderizado, el movimiento de datos y las cargas de trabajo de ML |
La pregunta sobre la 5090 solo es útil si la formulamos correctamente
La RTX 5090 es un ejemplo útil precisamente porque la evidencia es mixta. A fecha del 18 de octubre de 2026, NVIDIA sigue listando la GeForce RTX 5090 como un producto vigente. Al mismo tiempo, el comportamiento de los minoristas y los informes de prensa han documentado una disponibilidad inusualmente baja y afirmaciones no confirmadas de un cese de producción. Eso es una señal de mercado, no un anuncio oficial de fin de producción. Por lo tanto, la pregunta defendible no es si NVIDIA eliminó en secreto una tarjeta, sino si el coste de oportunidad de asignar silicio de gama alta de la clase Blackwell al gaming entusiasta aumenta cuando una arquitectura similar puede servir a los mercados de visualización profesional e IA con economías muy diferentes.
La memoria empieza a convertirse en un problema de cómputo, no solo de capacidad
Hay al menos cuatro formas de atacar un cuello de botella de memoria sin simplemente aumentar la velocidad bruta de la DRAM: comprimir la representación, reconstruir el detalle con cómputo, predecir qué datos se necesitarán a continuación y mantener los datos adecuados residentes cerca de la unidad de ejecución. Ninguna de ellas hace que un chip de memoria físico sea mágicamente más rápido. Cambian cuánto trabajo útil obtiene el sistema de un presupuesto finito de capacidad y ancho de banda.
| Técnica | Qué cambia | Qué no cambia automáticamente |
|---|---|---|
| Compresión | Menos bytes físicos representan los mismos datos lógicos | El reloj de la DRAM y el ancho del bus |
| Reconstrucción neuronal | Parte del detalle se genera a partir de una representación compacta | El coste desaparece; la inferencia tiene su propio coste de cómputo/latencia |
| Prefetch predictivo | Los datos llegan antes de que la carga de trabajo solicitante se bloquee | El ancho de banda físico total |
| Residencia / acceso unificado | Menos migración o duplicación innecesaria | Las restricciones de contención y latencia |
Cómo podría funcionar la respuesta técnica
Un posible futuro pipeline de fotogramas
Este pipeline no es un producto anunciado. Cada componente ya existe de alguna forma, pero la cadena integrada es la hipótesis. La compresión de texturas neuronal ha demostrado que las representaciones aprendidas pueden intercambiar cómputo por memoria. La investigación de prefetch en GPU ha demostrado que la predicción aprendida puede mejorar las tasas de acierto de páginas de memoria. DirectX está formalizando el ML dentro del modelo de programación gráfica. DLSS 5 muestra una etapa generativa entrando en el renderizado en tiempo real.
Un juego tiene una ventaja que las cargas de trabajo generales a menudo no tienen: ya conoce parte de su futuro
Un motor de juego conoce la transformación de cámara, la velocidad del jugador, la celda actual del mundo, las celdas de streaming vecinas, el estado de animación, las entidades activas, las transiciones de LOD, las dependencias de shaders y a menudo las rutas de recorrido probables. Ese contexto determinista no revela el futuro perfectamente, pero da a un predictor un punto de partida más rico que una traza de memoria genérica por sí sola.
Un ejemplo de memoria predictiva en gaming
Por qué una arquitectura tipo Spark se vuelve interesante
DGX Spark no es un PC de gaming, y tratarlo como tal ocultaría la lección útil. Su diseño GB10 combina núcleos de CPU Arm, una GPU Blackwell, hardware Tensor y RT, y hasta 128 GB de memoria de sistema unificada coherente. Esa arquitectura plantea una pregunta diferente a la de un escritorio clásico: en lugar de dividir el sistema limpiamente en memoria de CPU y VRAM discreta, ¿qué ocurre cuando múltiples motores de cómputo comparten un gran pool de memoria?
| Propiedad | Referencia de DGX Spark | Implicación para juegos si se adaptara el principio |
|---|---|---|
| Memoria | Hasta 128 GB LPDDR5X unificada coherente | Un gran pool compartido podría reducir la duplicación y dar acceso local a IA + gráficos a datos comunes |
| Ancho de banda de memoria | 273 GB/s | La capacidad no es suficiente; los gráficos de gama alta aún necesitan una gestión agresiva del ancho de banda y la latencia |
| Mezcla de cómputo | CPU + GPU Blackwell + Tensor + RT | Una futura carga de trabajo de juego podría dividirse entre motores más especializados |
| Factor de forma/energía | Sistema compacto GB10 | La integración puede mejorar la eficiencia pero puede reducir la capacidad de actualización modular |
¿Qué tendría que ser cierto para que esta transición funcione?
La prueba de viabilidad del juego neuronal
¿Qué debería esperar un comprador de una transición similar a Spark?
Beneficio potencial vs costo real
| Ganancia potencial | Costo / riesgo | |
|---|---|---|
| Gran pool coherente | Mayor flexibilidad de compartición entre CPU, gráficos e IA local | Los clientes compartidos pueden competir por el mismo ancho de banda |
| Menos duplicación | Menos copias entre pools separados de RAM del sistema y VRAM | La coherencia y la planificación añaden complejidad |
| Más margen para IA local | Modelos más grandes, agentes o recursos neuronales pueden coexistir localmente | La IA puede competir con los gráficos por cómputo y memoria |
| Optimización a nivel de sistema | La plataforma puede optimizar conjuntamente la ubicación de datos y los aceleradores | Una integración más estrecha puede reducir la actualización y aumentar el bloqueo |
| Nueva flexibilidad de carga de trabajo | Una máquina puede envejecer mejor si los futuros juegos se orientan a cargas neuronales | Solo si los motores y runtimes realmente usan esas capacidades |
¿Qué falsificaría esta hipótesis?
Esta tesis es deliberadamente falsificable. La siguiente tabla define las señales de mercado, software, hardware y adopción de juegos que harían el argumento más fuerte o más débil con el tiempo.
Evidencia que fortalece o debilita la tesis
| La fortalecería | La debilitaría | |
|---|---|---|
| Economía de la memoria | La prioridad de servidores/HBM continúa presionando la asignación para consumo | La capacidad de consumo se expande y la presión de precios se normaliza |
| Pila de gráficos | Las primitivas de ML se convierten en características normales del motor/DirectX | Los gráficos neuronales siguen siendo postprocesado opcional específico de cada proveedor |
| Diseño de hardware | Más cómputo heterogéneo integrado y pools de memoria coherente más grandes | GPU discreta + RAM separada sigue siendo claramente superior en costo, flexibilidad y latencia |
| Adopción en juegos | Los estudios lanzan ampliamente compresión neuronal, generación y rutas de datos predictivas | La tecnología sigue limitada a demos o unos pocos juegos insignia |
La conclusión práctica para un jugador hoy
No compres hardware porque podría llegar una arquitectura especulativa. Compra para los juegos, la resolución, el objetivo de latencia y las cargas de trabajo que realmente tienes. Pero no asumas que la preparación para el futuro puede reducirse todavía a un solo número como el rendimiento de rasterización o la capacidad de VRAM. La dirección de la pila de software sugiere que el comportamiento de la memoria, el cómputo neuronal y el soporte del motor pueden volverse partes cada vez más importantes de la ecuación de valor.
Fuentes primarias
Newzoo — Cifras clave del mercado global de juegos 2026Pronóstico del mercado de juegos 2026 utilizado para la comparación de escala.
Semiconductor Industry Association — Ventas globales 2025Ventas de semiconductores 2025 y la proyección de la asociación de aproximadamente 1 billón de dólares para 2026.
TrendForce — La demanda de servidores de IA sostiene los aumentos de precios de memoria en el 4T26Evidencia de finales de 2026 sobre la asignación continua de capacidad prioritaria para servidores y la presión sobre el consumo.
NVIDIA Research — Compresión BuddyFuente de investigación para las tasas de compresión promedio de 2,2× en HPC y 1,5× en DL.
Precarga UVM CPU–GPU basada en aprendizaje profundoFuente de investigación para los resultados de precarga de páginas aprendida.
AAAI 2026 — Prefetching asíncrono de caché KVFuente de investigación que demuestra la ocultación de latencia mediante el prefetching proactivo de la caché de GPU.
TrendForce — Demanda de servidores de IA y precios de memoria para el 2T26Evidencia actual sobre la priorización de servidores/HBM, las restricciones de GDDR y la presión sobre el consumidor.
Microsoft DirectX — Evolución de DirectX para la era del MLResumen oficial de la GDC 2026 sobre ML a nivel de shader y de modelo en DirectX.
NVIDIA Research — DLSS 5: Renderizado neuronal generativoPágina de investigación principal que describe DLSS 5 como una etapa de renderizado generativo en tiempo real.
NVIDIA — Especificaciones de DGX SparkEspecificaciones oficiales de arquitectura, memoria unificada y ancho de banda.
NVIDIA — GeForce RTX 5090Página oficial actual del producto RTX 5090 utilizada para distinguir el estado confirmado del producto de los rumores de detención de producción.
Tom’s Hardware — Desaparición de la RTX 5090 en el comercio minorista y rumores de detención de producciónInforme de mercado actual utilizado únicamente como señal de la industria; señala explícitamente que NVIDIA no ha confirmado una detención de producción.
NVIDIA Research — Compresión neuronal de acceso aleatorio de texturas de materialesFuente principal de la comparación de 4× de resolución lineal / 16× de texel con un 30% menos de memoria frente a BC High.
NVIDIA — RTX PRO 6000 Blackwell Workstation EditionFuente oficial de los 96 GB de GDDR7 y 1.792 GB/s de ancho de banda de memoria utilizados como punto de referencia de ancho de banda.
Conceptos clave
- Renderizado neuronal
- Métodos de renderizado que utilizan modelos entrenados como parte de la producción, reconstrucción o mejora de la salida visual.
- Cómputo heterogéneo
- Sistema que asigna diferentes cargas de trabajo a distintos motores de cómputo, como CPU, GPU, RT y hardware de matriz/Tensor.
- Memoria efectiva
- Descripción práctica de cuántos datos útiles puede retener y alimentar al cómputo un sistema de memoria tras considerar la compresión, la residencia y la eficiencia de movimiento. No es un reemplazo formal de la capacidad física.
- Memoria predictiva
- Término abreviado de Figure Rocks para combinar el estado conocido del juego y la predicción aprendida para preparar los datos probablemente necesarios antes de una pausa. Es una hipótesis, no un estándar de la industria.
Durante décadas, los juegos de PC para entusiastas siguieron un pacto familiar: los juegos exigían más cómputo, las generaciones de GPU ofrecían más cómputo y los jugadores actualizaban cuando la brecha se volvía lo suficientemente grande. Ese ciclo nunca funcionó a la perfección, pero la dirección era comprensible. En 2026, el ciclo se está volviendo más difícil de interpretar porque están ocurriendo dos cambios al mismo tiempo: la infraestructura de IA compite agresivamente por silicio y memoria, mientras que las técnicas de IA se trasladan directamente a la forma en que los juegos crean fotogramas.
La disparidad de escala ya es visible
Newzoo pronostica que el mercado global de videojuegos alcanzará los 213.900 millones de dólares en 2026, un 6,1% más interanual. La Semiconductor Industry Association informó ventas globales de semiconductores por 791.700 millones de dólares en 2025, un 25,6% más, y proyectó aproximadamente 1 billón para 2026. El negocio de los videojuegos y el de los semiconductores todavía dependen el uno del otro, pero sus incentivos se están volviendo menos simétricos: el mismo ecosistema de fabricación avanzada que habilita los juegos de gama alta ahora atiende a compradores de IA y centros de datos con presupuestos de infraestructura mucho mayores. No son categorías de productos directamente comparables; establecen la escala de la economía de cómputo upstream en torno a los videojuegos.
| Punto de referencia | Valor reportado o pronosticado | Por qué importa aquí |
|---|---|---|
| Mercado global de videojuegos, pronóstico 2026 | 213.900 M$, +6,1% interanual | Gran mercado de entretenimiento de consumo, pero aguas abajo del suministro de hardware avanzado |
| Juegos de PC, pronóstico 2026 | 45.900 M$, +5,3% interanual | El segmento de juegos más directamente expuesto a la economía de los componentes de PC |
| Ventas globales de semiconductores, 2025 | 791.700 M$, +25,6% interanual | Muestra la escala de la industria upstream que sirve a juegos, IA, móviles, automoción y nube |
| Industria global de semiconductores, proyección 2026 | ~1 billón | Aumenta el costo de oportunidad de dedicar silicio de gama alta solo a juegos de consumo |
La memoria es donde la presión se vuelve concreta
TrendForce ha informado repetidamente que los proveedores de DRAM están desplazando capacidad hacia productos para servidores y HBM a medida que crece la demanda de IA. En marzo de 2026 pronosticó que los precios de contrato de la DRAM convencional aumentarían entre un 58 % y un 63 % trimestre tras trimestre en el segundo trimestre y afirmó que la asignación limitada de GDDR estaba restringiendo el suministro de memoria gráfica. Para el tercer trimestre, TrendForce indicó que los clientes de consumo estaban alcanzando un límite de asequibilidad incluso cuando la demanda de IA y servidores seguía siendo fuerte.
La presión de asignación de recursos
Exactamente al mismo tiempo, el marco mismo está cambiando
Microsoft ahora describe el aprendizaje automático como algo que se está volviendo fundamental para los gráficos en tiempo real. DirectX está añadiendo rutas de ML a nivel de shader y de modelo para que la compresión de texturas neuronal, la reducción de ruido, la superresolución y otras cargas de trabajo aprendidas puedan situarse dentro de la pila gráfica en lugar de añadirse como características aisladas. La investigación de DLSS 5 de NVIDIA lleva la idea más lejos al introducir una etapa de renderizado neuronal generativo que complementa el renderizado convencional con priors de apariencia aprendidos. El renderizado neuronal no significa que el renderizado convencional desaparezca. El modelo emergente es híbrido: renderizar alguna información directamente, inferir o reconstruir otra información cuando hacerlo es más barato o más útil.
Escalado tradicional vs escalado de la era neuronal
| Ruta tradicional | Ruta de la era neuronal | |
|---|---|---|
| Más fidelidad visual | Almacenar más detalles y renderizar más trabajo | Almacenar/renderizar selectivamente, reconstruir o inferir algunos detalles |
| Respuesta de memoria | Añadir capacidad y ancho de banda | Añadir capacidad donde sea necesario, pero también comprimir y reducir el movimiento |
| Respuesta de rendimiento | Más rendimiento de shader/RT | Mezclar shader, RT y cómputo estilo matriz/Tensor |
| Rol del software | El motor programa principalmente trabajo gráfico convencional | El motor programa cada vez más el renderizado, el movimiento de datos y las cargas de trabajo de ML |
La pregunta sobre la 5090 solo es útil si la formulamos correctamente
La RTX 5090 es un ejemplo útil precisamente porque la evidencia es mixta. A partir del 18 de octubre de 2026, NVIDIA sigue listando la GeForce RTX 5090 como un producto actual. Al mismo tiempo, el comportamiento de los minoristas y los informes de prensa han documentado una disponibilidad inusualmente baja y afirmaciones no confirmadas de un alto en la producción. Eso es una señal de mercado, no un anuncio oficial de fin de producción. La pregunta defendible, por lo tanto, no es si NVIDIA eliminó secretamente una tarjeta, sino si el costo de oportunidad de asignar silicio de gama alta de clase Blackwell al gaming entusiasta aumenta cuando una arquitectura similar puede servir a mercados de visualización profesional e IA con economías muy diferentes.
La memoria está empezando a convertirse en un problema de cómputo, no solo de capacidad
Hay al menos cuatro formas de atacar un cuello de botella de memoria sin simplemente aumentar la velocidad bruta de la DRAM: comprimir la representación, reconstruir detalles con cómputo, predecir qué datos se necesitarán a continuación y mantener los datos correctos residentes cerca de la unidad de ejecución. Ninguna de estas hace que un chip de memoria físico sea mágicamente más rápido. Cambian cuánto trabajo útil obtiene el sistema de un presupuesto finito de capacidad y ancho de banda.
| Técnica | Qué cambia | Qué no cambia automáticamente |
|---|---|---|
| Compresión | Menos bytes físicos representan los mismos datos lógicos | El reloj de la DRAM y el ancho del bus |
| Reconstrucción neuronal | Algunos detalles se generan a partir de una representación compacta | El costo desaparece; la inferencia tiene su propio costo de cómputo/latencia |
| Prefetch predictivo | Los datos llegan antes de que la carga de trabajo solicitante se detenga | El ancho de banda físico total |
| Residencia / acceso unificado | Menos migración o duplicación innecesaria | Las restricciones de contención y latencia |
Cómo podría funcionar la respuesta técnica
Un posible futuro pipeline de fotogramas
Este pipeline no es un producto anunciado. Cada componente ya existe de alguna forma, pero la cadena integrada es la hipótesis. La compresión de texturas neuronal ha demostrado que las representaciones aprendidas pueden intercambiar cómputo por memoria. La investigación sobre precarga en GPU ha demostrado que la predicción aprendida puede mejorar las tasas de acierto de páginas de memoria. DirectX está formalizando el ML dentro del modelo de programación gráfica. DLSS 5 muestra una etapa generativa entrando en la renderización en tiempo real.
Un juego tiene una ventaja que las cargas de trabajo generales a menudo no tienen: ya conoce parte de su futuro
Un motor de juego conoce la transformación de la cámara, la velocidad del jugador, la celda actual del mundo, las celdas de streaming vecinas, el estado de la animación, las entidades activas, las transiciones de LOD, las dependencias de shaders y, a menudo, las rutas de recorrido probables. Ese contexto determinista no revela el futuro perfectamente, pero le da a un predictor un punto de partida más rico que una traza de memoria genérica por sí sola.
Un ejemplo de memoria de juego predictiva
Por qué una arquitectura similar a Spark se vuelve interesante
DGX Spark no es un PC para juegos, y tratarlo como tal ocultaría la lección útil. Su diseño GB10 combina núcleos de CPU Arm, una GPU Blackwell, hardware Tensor y RT, y hasta 128 GB de memoria de sistema unificada coherente. Esa arquitectura plantea una pregunta diferente a la de un escritorio clásico: en lugar de dividir el sistema limpiamente en memoria de CPU y VRAM discreta, ¿qué sucede cuando múltiples motores de cómputo comparten un gran pool de memoria?
| Propiedad | Referencia de DGX Spark | Implicación para juegos si se adaptara el principio |
|---|---|---|
| Memoria | Hasta 128 GB LPDDR5X unificada coherente | Un gran pool compartido podría reducir la duplicación y dar acceso local a IA + gráficos a datos comunes |
| Ancho de banda de memoria | 273 GB/s | La capacidad no es suficiente; los gráficos de gama alta aún necesitan una gestión agresiva de ancho de banda y latencia |
| Mezcla de cómputo | CPU + GPU Blackwell + Tensor + RT | Una futura carga de trabajo de juego podría dividirse entre más motores especializados |
| Factor de forma/energía | Sistema compacto GB10 | La integración puede mejorar la eficiencia pero puede reducir la capacidad de actualización modular |
¿Qué tendría que ser cierto para que esta transición funcione?
La prueba de viabilidad del juego neuronal
¿Qué debería esperar un comprador de una transición similar a Spark?
Beneficio potencial vs coste real
| Ganancia potencial | Coste / riesgo | |
|---|---|---|
| Gran pool coherente | Mayor flexibilidad de compartición entre CPU, gráficos e IA local | Los clientes compartidos pueden competir por el mismo ancho de banda |
| Menos duplicación | Menos copias entre pools separados de RAM del sistema y VRAM | La coherencia y la planificación añaden complejidad |
| Más margen para IA local | Modelos más grandes, agentes o activos neuronales pueden coexistir localmente | La IA puede competir con los gráficos por cómputo y memoria |
| Optimización a nivel de sistema | La plataforma puede optimizar la colocación de datos y los aceleradores juntos | Una integración más estrecha puede reducir la capacidad de actualización y aumentar el bloqueo |
| Nueva flexibilidad de carga de trabajo | Una máquina puede envejecer mejor si los futuros juegos se orientan hacia cargas de trabajo neuronales | Solo si los motores y runtimes realmente usan esas capacidades |
¿Qué falsificaría esta hipótesis?
Esta tesis es deliberadamente falsificable. La siguiente tabla define las señales de mercado, software, hardware y adopción de juegos que harían el argumento más fuerte o más débil con el tiempo.
Evidencia que fortalece o debilita la tesis
| La fortalecería | La debilitaría | |
|---|---|---|
| Economía de la memoria | La prioridad de servidores/HBM sigue presionando la asignación para consumidores | La capacidad del consumidor se expande y la presión de precios se normaliza |
| Pila gráfica | Las primitivas de ML se convierten en características normales de motores/DirectX | Los gráficos neuronales siguen siendo un posprocesamiento opcional específico de cada proveedor |
| Diseño de hardware | Más cómputo heterogéneo integrado y grupos de memoria coherente más grandes | La GPU discreta + RAM separada sigue siendo claramente superior en costo, flexibilidad y latencia |
| Adopción en juegos | Los estudios lanzan ampliamente compresión neuronal, generación y rutas de datos predictivas | La tecnología sigue limitada a demos o unos pocos juegos insignia |
La conclusión práctica para un jugador hoy
No compres hardware porque podría llegar una arquitectura especulativa. Compra para los juegos, la resolución, el objetivo de latencia y las cargas de trabajo que realmente tienes. Pero no asumas que la preparación para el futuro aún pueda reducirse a un solo número, como el rendimiento de rasterización o la capacidad de VRAM. La dirección de la pila de software sugiere que el comportamiento de la memoria, el cómputo neuronal y el soporte del motor pueden volverse partes cada vez más importantes de la ecuación de valor.
Fuentes primarias
Newzoo — Cifras clave del mercado global de juegos 2026Pronóstico del mercado de juegos para 2026 utilizado para la comparación de escala.
Semiconductor Industry Association — Ventas globales 2025Ventas de semiconductores de 2025 y la proyección de la asociación de aproximadamente 1 billón de dólares para 2026.
TrendForce — La demanda de servidores de IA sostiene los aumentos de precios de memoria en el 4T26Evidencia de finales de 2026 sobre la asignación continua de capacidad prioritaria para servidores y la presión sobre los consumidores.
NVIDIA Research — Buddy CompressionFuente de investigación para las relaciones de compresión promedio de 2,2× en HPC y 1,5× en DL.
Prefetching UVM CPU–GPU basado en aprendizaje profundoFuente de investigación para los resultados de prefetching de páginas aprendido.
AAAI 2026 — Prefetching asíncrono de caché KVFuente de investigación que demuestra el ocultamiento de latencia mediante el prefetching proactivo de la caché de GPU.
TrendForce — Demanda de servidores de IA y precios de memoria en el 2T26Evidencia actual sobre la priorización de servidores/HBM, las restricciones de GDDR y la presión sobre los consumidores.
Microsoft DirectX — Evolución de DirectX para la era del MLResumen oficial de GDC 2026 sobre ML a nivel de shader y de modelo en DirectX.
NVIDIA Research — DLSS 5: renderizado neuronal generativoPágina de investigación primaria que describe DLSS 5 como una etapa de renderizado generativo en tiempo real.
NVIDIA — Especificaciones de DGX SparkEspecificaciones oficiales de arquitectura, memoria unificada y ancho de banda.
NVIDIA — GeForce RTX 5090Página oficial del producto RTX 5090 actual utilizada para distinguir el estado confirmado del producto de los rumores de cese de producción.
Tom’s Hardware — Desaparición minorista de la RTX 5090 y rumores de cese de producciónInforme de mercado actual utilizado solo como señal de la industria; señala explícitamente que NVIDIA no ha confirmado un cese de producción.
NVIDIA Research — Compresión neuronal de acceso aleatorio de texturas de materialesFuente primaria para la comparación de 4× resolución lineal / 16× texel con un 30% menos de memoria frente a BC High.
NVIDIA — RTX PRO 6000 Blackwell Workstation EditionFuente oficial de 96 GB GDDR7 y 1.792 GB/s de ancho de banda de memoria utilizada como punto de referencia de ancho de banda.
Conceptos clave
- Renderizado neuronal
- Métodos de renderizado que utilizan modelos entrenados como parte de la producción, reconstrucción o mejora de la salida visual.
- Cómputo heterogéneo
- Un sistema que asigna diferentes cargas de trabajo a distintos motores de cómputo, como CPU, GPU, RT y hardware de matriz/Tensor.
- Memoria efectiva
- Una descripción práctica de cuántos datos útiles puede retener y suministrar al cómputo un sistema de memoria tras considerar la compresión, la residencia y la eficiencia de movimiento. No es un reemplazo formal de la capacidad física.
- Memoria predictiva
- Abreviatura de Figure Rocks para combinar el estado conocido del juego y la predicción aprendida para preparar los datos probablemente necesarios antes de una pausa. Es una hipótesis, no un estándar de la industria.
Related Articles
Lista de verificación rápida de la sensación de juego: Corrige el timing antes de actualizar nada
Una lista de verificación rápida para mejorar la capacidad de respuesta, la fluidez y la claridad sin comprar equipo nuevo. Diagnostica primero el timing, luego ajusta la configuración y después actualiza.
Ergonomía para sesiones largas: comodidad que previene la fatiga
La comodidad es rendimiento. Utiliza esta base ergonómica sencilla para reducir la fatiga, mantener un control constante y jugar por más tiempo sin dolor.
Gaming centrado en la experiencia: El manual anticarrera
Una guía fundamental para jugadores cansados de la carrera de especificaciones. Sensación de construcción, estabilidad y gusto: mejor juego, actualizaciones más tranquilas, valor a largo plazo.
Más allá del escaneo – Usos creativos y modificaciones de amiibo"
amiibo son figuras de personajes equipadas con NFC lanzadas por Nintendo desde 2014. Técnicamente, son pequeños soportes de datos dentro de figuras de plástico moldeado. En la práctica, se sitúan en algún punto entre juguete, objeto de colección y dispositivo de interfaz. Escanearlos en una consola es solo una parte de su ciclo de vida. Observado a lo largo de los años, muchos propietarios los tratan como objetos con su propio potencial creativo.
Comodidad en el Gaming: Ergonomía que previene la fatiga (Sesiones largas, sin dolor)
La comodidad es rendimiento. Aprende una base práctica de ergonomía para la silla, el escritorio, el monitor y los controles para reducir la fatiga y mantener la consistencia durante sesiones largas.
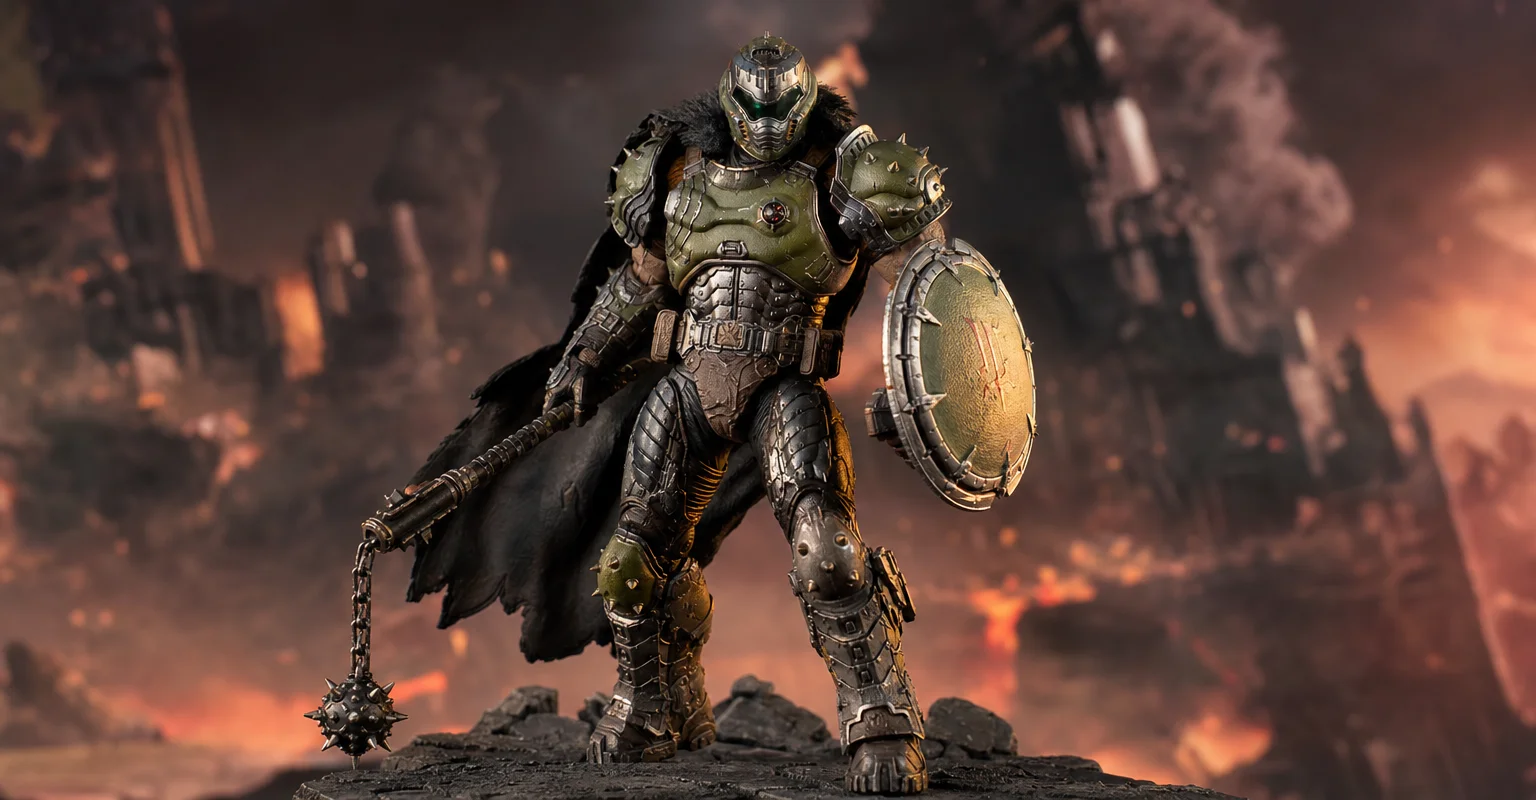
Alerta de preventa: Good Smile Company Figma Doom: The Dark Ages – Doom Slayer DX Edition
La nueva Good Smile Company Figma Doom: The Dark Ages Doom Slayer DX Edition es más que un lanzamiento rutinario de una figura. Conecta la demanda de los coleccionistas, la identidad de la franquicia y el atractivo más amplio de Doom como uno de los iconos más duraderos de los videojuegos.
Gestión de colas para gaming: Detén los picos de bufferbloat bajo carga
Bufferbloat es la razón por la que tu juego se siente pesado cuando alguien sube contenido o transmite. Aprende el orden práctico: medir bajo carga, gestionar colas y luego actualizar el hardware.
Cómo probamos el equipo: un método sencillo centrado en la experiencia
Un método claro: definir el resultado, estabilizar la cadena, probar un solo cambio y conservar solo lo que mejore el juego real.
Próximos amiibo de Nintendo – Nuevas figuras, ventanas de lanzamiento e importancia funcional
Los amiibo son figuras físicas equipadas con chips NFC que se comunican con las consolas de Nintendo. Desbloquean objetos dentro del juego, elementos cosméticos o pequeñas funciones de juego en títulos compatibles. Este resumen del catálogo se centra en los próximos amiibo anunciados oficialmente, sus ventanas de lanzamiento previstas, su valor funcional y su posición dentro de la estructura de oleadas más amplia.
Configuración base para gaming: ritmo de fotogramas, VRR y latencia (PC + consola)
Una base práctica que hace que todo se sienta mejor antes de comprar nada: cadencia de fotogramas estable, VRR correcto y latencia reducida para PC y consolas.
El motor de juego se está convirtiendo en parte renderizador, parte planificador, parte sistema de IA
Los motores de juego se utilizaban para orquestar la simulación y el renderizado. Los gráficos neuronales, la memoria predictiva y los agentes de juego están añadiendo una tercera responsabilidad: decidir dónde encaja la inferencia dentro del fotograma y del estado del juego.
La Trinidad de la Sensación: Claridad, Capacidad de respuesta, Comodidad
El modelo central detrás de figure.rocks. Tres resultados que deciden si el gaming se siente premium o miserable — independientemente de la plataforma.