
NVIDIA RTX Spark mette DLSS 5 e i personaggi IA locali sulla stessa piattaforma di gioco
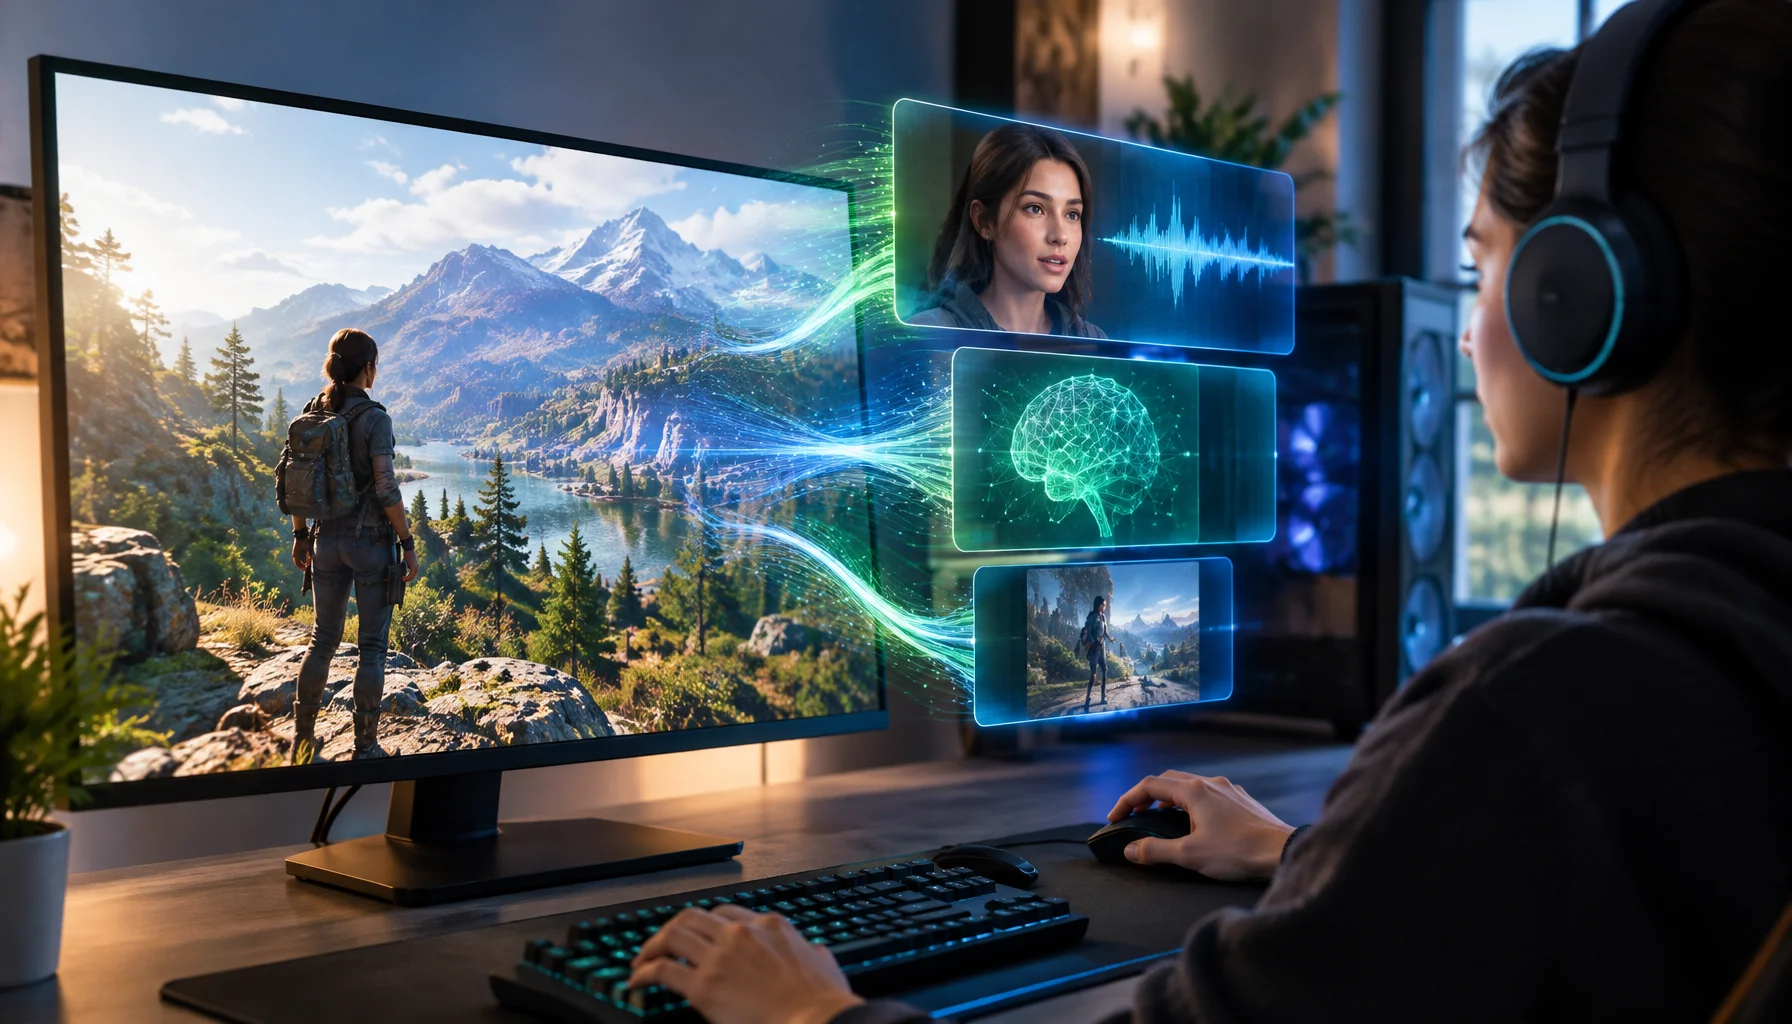
Il 27 ottobre 2026, NVIDIA ha posizionato RTX Spark come qualcosa di più di una nuova piattaforma PC Windows. L'azienda sta portando due diversi tipi di carico di lavoro AI sulla stessa macchina da gaming: il rendering neurale tramite DLSS 5 e l'intelligenza dei personaggi locale tramite NVIDIA ACE e Nemotron 3.5 Bolt E4B 4GB.
Questa combinazione è la vera notizia. I giochi stanno iniziando a usare l'AI locale non solo per ricostruire o generare pixel, ma anche per interpretare l'intento del giocatore, ragionare sullo stato del gioco, chiamare strumenti e guidare il comportamento dei personaggi. La sfida tecnica non è più solo se un modello può essere eseguito. È se grafica, voce e inferenza degli agenti possono condividere memoria, calcolo e budget di latenza senza danneggiare il gioco stesso.
Risposta diretta
RTX Spark è la nuova piattaforma PC Windows di NVIDIA per lo sviluppo AI, la creazione e il gaming, costruita attorno a una GPU Blackwell RTX e una CPU Grace con fino a 128 GB di memoria unificata. Per i giochi, NVIDIA sta abbinando quella piattaforma a DLSS 5, RTX Kit, supporto a Unreal Engine 5.8 e un nuovo piccolo modello linguistico, Nemotron 3.5 Bolt E4B 4GB, progettato per personaggi AI locali.
Il cambiamento architetturale più importante è che la grafica neurale e il ragionamento degli agenti di gioco stanno diventando carichi di lavoro concorrenti. Un gioco futuro potrebbe usare un percorso AI per migliorare l'immagine renderizzata mentre un altro modello ascolta il giocatore, legge lo stato rilevante, ragiona su una richiesta e seleziona un'azione di gioco consentita.
Cosa ha annunciato NVIDIA il 27 ottobre 2026
NVIDIA afferma che RTX Spark combina fino a 128 GB di memoria unificata con lo stack software CUDA, ray tracing e la suite DLSS completa. Lo stack per il gaming include anche le tecnologie RTX Kit, gli strumenti di sviluppo Nsight, una RTX Branch di Unreal Engine 5.8 e l'In-Game Inferencing SDK usato per eseguire modelli linguistici e vocali locali.
L'aggiornamento lato personaggi si concentra su Nemotron 3.5 Bolt E4B 4GB. NVIDIA ha rilasciato il modello stesso il 23 ottobre, poi ne ha evidenziato il ruolo nel gaming quattro giorni dopo. Il modello è disponibile per gli sviluppatori tramite l'In-Game Inferencing SDK ed è ottimizzato per agenti conversazionali che devono essere eseguiti localmente lasciando risorse disponibili per il resto dell'applicazione.
Sul fronte del rendering, DLSS 5 con 3D-Guided Neural Rendering è supportato su RTX Spark, a partire da NBA 2K27. NVIDIA afferma che il suo aggiornamento del modello DLSS 5 di ottobre è due volte più veloce della versione di settembre, dimezza il sovraccarico della GPU e usa il 20% in meno di VRAM a 4K mantenendo una fedeltà visiva comparabile. Queste sono le misurazioni di NVIDIA e dovrebbero essere considerate come dichiarazioni di prestazioni del produttore fino a test indipendenti.
Il vero cambiamento: il PC da gaming diventa un runtime AI condiviso
L'AI locale nei giochi ha un vincolo più difficile di un chatbot desktop: non possiede la macchina. Il gioco sta già consumando tempo GPU, larghezza di banda della memoria, VRAM o memoria unificata, tempo CPU, larghezza di banda dello storage e budget di frame-time. Il riconoscimento vocale e la sintesi vocale possono aggiungere un ulteriore livello di competizione.
Ciò rende l'efficienza per gigabyte più importante della dimensione grezza del modello. NVIDIA descrive Nemotron 3.5 Bolt E4B come adatto a circa 4 GB per i suoi carichi di lavoro target, in modo che l'inferenza locale dei personaggi possa coesistere con la grafica e altri modelli. L'obiettivo di progettazione non è quindi semplicemente un NPC più intelligente. È un modello che può rimanere utile mentre il gioco sta ancora renderizzando.
Questo è anche il motivo per cui RTX Spark conta come storia di piattaforma piuttosto che come annuncio di un singolo modello. Rendering neurale, ragionamento linguistico, voce e logica di gioco tradizionale stanno convergendo sulla stessa macchina, ma hanno ancora requisiti di temporizzazione diversi e diversa autorità sul gioco.
Cosa aggiunge Nemotron 3.5 Bolt ai personaggi di gioco locali
Nemotron 3.5 Bolt E4B 4GB è costruito per carichi di lavoro conversazionali e agentici piuttosto che per il controllo frame-by-frame. NVIDIA elenca tra le sue capacità principali l'uso autonomo di strumenti multi-turno, l'aderenza alle istruzioni, il ragionamento configurabile e l'ancoraggio allo stato del gioco.
Il modello supporta una finestra di contesto di 64K che può contenere cronologia delle conversazioni, istruzioni, definizioni degli strumenti, informazioni recuperate e stato del gioco. Supporta anche 35 lingue, mentre NVIDIA afferma che il modello base è stato preaddestrato su più di 140 lingue.
NVIDIA riporta una qualità media superiore di circa il 40% rispetto al suo modello precedente su benchmark rilevanti selezionati e fino a circa l'80% in meno di token di output rispetto ai modelli concorrenti. Questi numeri descrivono i risultati dei benchmark di NVIDIA, non un miglioramento garantito nella credibilità degli NPC, nella latenza del gioco o nel frame pacing.
C'è anche un'importante distinzione temporale. Il compagno AI in beta pubblica di PUBG usa il piccolo modello linguistico Nemotron di prima generazione di NVIDIA, mentre Aniimo ha dimostrato un modello Nemotron di seconda generazione. Nemotron 3.5 Bolt è il nuovo modello per sviluppatori annunciato ora; NVIDIA non ha detto che quelle implementazioni esistenti siano già migrate ad esso.
Figure Rocks ha già esaminato questa separazione in PUBG Ally Shows Why AI Teammates Need Two Brains: il ragionamento linguistico è utile per la pianificazione, il coordinamento e l'interpretazione, mentre le reazioni rapide in combattimento appartengono ancora a sistemi deterministici o specializzati lato gioco.
Contesto 64K, retrieval, stato live e strumenti non sono la stessa cosa
Una finestra di contesto di 64K aumenta la quantità di informazioni che un modello può considerare contemporaneamente, ma non rende automaticamente il personaggio competente, aggiornato o corretto. La capacità di contesto risponde a quanta informazione può essere fornita. Il retrieval decide quali conoscenze esterne devono essere fornite. Lo stato live del gioco descrive ciò che è vero nella sessione corrente. Gli strumenti definiscono cosa l'agente è autorizzato a ispezionare o fare.
L'ACE Game Agent SDK di NVIDIA riflette direttamente questa separazione. La sua Agent API gestisce un ragionamento con stato, multi-step e assistito da strumenti; la sua Chat API offre agli sviluppatori un controllo di livello inferiore sull'inferenza; e la sua RAG API supporta il retrieval semantico, lessicale e ibrido da database costruiti dagli sviluppatori. NVIDIA ha già dimostrato questa architettura di retrieval nel consulente sperimentale di Total War: PHARAOH, che interroga più di 1.200 tabelle di dati di gioco interconnesse.
Per un personaggio di gioco, questi livelli dovrebbero rimanere distinti. Un database di conoscenze può dire come funziona un oggetto. Lo stato attuale del gioco deve dire se l'oggetto è effettivamente presente. Il modello può decidere che usare l'oggetto sia sensato. Una funzione validata lato gioco deve comunque decidere se quell'azione è lecita ed eseguirla.
L'inferenza locale inoltre non significa che l'intero gioco diventi offline. Il modello linguistico può essere eseguito sulla macchina del giocatore mentre i server multiplayer, i sistemi di account, i contenuti scaricabili o altri servizi richiedono ancora una connessione di rete.
DLSS 5 trasforma la stessa macchina in una piattaforma di rendering AI
DLSS 5 introduce il 3D-Guided Neural Rendering come un'altra fase della pipeline grafica. NVIDIA lo descrive come un miglioramento dell'illuminazione e dei dettagli dei materiali a partire dal frame renderizzato dal motore, preservando il controllo degli sviluppatori su ciò che può cambiare. La geometria, le texture, i buffer di illuminazione e la scena autoriale esistenti rimangono la base.
Questa distinzione è importante perché il rendering neurale non è un sostituto del motore di gioco. È uno strato di inferenza che opera su informazioni già fornite dal motore. Lo stesso principio appare sul lato agente: un modello linguistico può interpretare e decidere, ma il motore di gioco rimane l'autorità sullo stato valido e sulle azioni eseguibili.
L'architettura più ampia è esplorata in The Game Engine Is Becoming Part Renderer, Part Scheduler, Part AI System. RTX Spark rende questa convergenza più concreta perché l'inferenza di rendering e l'inferenza dell'agente sono ora progettate come carichi di lavoro che devono coesistere su un unico sistema locale.
Perché RTX Spark è importante per gli sviluppatori di giochi
RTX Spark non è solo un pacchetto di funzionalità per i consumatori. NVIDIA sta fornendo un percorso di sviluppo attorno ad esso: supporto di Unreal Engine 5.8 per Windows on Arm, strumenti di profilazione Nsight, l'In-Game Inferencing SDK e otto tecnologie RTX Kit che coprono aree come la compressione neurale delle texture, gli shader neurali, la geometria, il denoising, il rendering dei personaggi e l'illuminazione globale.
L'implicazione pratica è che gli sviluppatori possono profilare sempre più la grafica e l'AI locale come parti di un unico budget di runtime, invece di trattare l'AI come un servizio remoto con assunzioni separate di latenza e costo. Ciò crea nuove possibilità, ma rende anche più importanti la pianificazione, la pressione sulla memoria e il comportamento nel caso peggiore del frame-time.
Cosa i giocatori non dovrebbero ancora dare per scontato
Il supporto di RTX Spark non significa che ogni gioco conterrà improvvisamente personaggi AI non scriptati. Gli sviluppatori devono ancora progettare il personaggio, esporre osservazioni e azioni sicure, integrare l'interazione vocale o testuale, definire il comportamento della memoria e decidere quando l'inferenza del modello vale il costo di runtime.
Anche le dichiarazioni sulle prestazioni di DLSS 5 non dimostrano che ogni gioco supportato risulterà più reattivo. Frame rate visualizzati più alti, frame generati, qualità della ricostruzione neurale e latenza di input sono misure correlate ma separate. Una funzionalità grafica può migliorare la fluidità visiva senza ridurre ogni componente della latenza end-to-end.
Allo stesso modo, un modello linguistico locale più potente non rende deterministico il comportamento del gioco. Il dialogo aperto e il ragionamento possono migliorare l'adattabilità, ma i sistemi scriptati rimangono più facili da testare e più prevedibili per comportamenti in cui la risposta corretta è già nota.
Cosa è confermato, cosa è un'affermazione del produttore e cosa è ancora sconosciuto
Confermato da NVIDIA: RTX Spark è una piattaforma PC Windows costruita attorno a grafica Blackwell RTX e CPU Grace; i sistemi possono fornire fino a 128 GB di memoria unificata; DLSS 5 e lo stack di gioco RTX sono supportati; Nemotron 3.5 Bolt E4B 4GB è disponibile per gli sviluppatori; il modello supporta contesto 64K, uso di strumenti, ragionamento configurabile e ancoraggio allo stato di gioco.
Dichiarazioni di benchmark del produttore: NVIDIA riporta una qualità media superiore di circa il 40% rispetto al suo modello precedente su benchmark selezionati, fino a circa l'80% in meno di token di output rispetto ai concorrenti, e un modello DLSS 5 di ottobre che funziona il doppio più velocemente della versione di settembre, dimezzando il sovraccarico della GPU e riducendo l'uso della VRAM in 4K del 20%.
Ancora sconosciuto da questo annuncio: l'impatto reale sul frame-time del rendering simultaneo, dell'inferenza vocale e dei personaggi su diversi sistemi RTX Spark; misurazioni indipendenti della latenza di risposta degli NPC sotto carico di gioco; quante partite commerciali adotteranno Nemotron 3.5 Bolt; e come gli sviluppatori bilanceranno la qualità dell'IA locale rispetto al gameplay deterministico e ai requisiti hardware.
Il parere di Figure Rocks
La parte più importante dell'annuncio NVIDIA del 27 ottobre non è un singolo benchmark o una demo di NPC IA. È l'idea emergente del PC da gioco come runtime IA condiviso. Grafica neurale, voce, recupero, ragionamento e logica di gioco competono e cooperano sempre più all'interno dello stesso frame-time e della stessa dotazione di memoria.
Se quell'architettura funziona sotto carico reale, i personaggi IA locali potrebbero diventare meno dipendenti dai round trip cloud e più strettamente connessi allo stato di gioco in tempo reale, mentre il rendering neurale continua a consumare potenza di calcolo IA per l'immagine stessa. Questo è un cambiamento significativo nel modo in cui i giochi vengono costruiti: la domanda si sposta dal se un gioco usa l'IA a quali carichi di lavoro IA meritano risorse locali, quando devono essere eseguiti e quale autorità riceve ciascuno.
Fonti primarie e ambito
Questo articolo si basa principalmente sull'annuncio gaming RTX Spark del 27 ottobre 2026 di NVIDIA, sulla release di ricerca Nemotron 3.5 Bolt E4B 4GB pubblicata il 23 ottobre, e sulla documentazione ed esempi dell'ACE Game Agent SDK di NVIDIA.
Dove NVIDIA fornisce numeri di prestazioni o qualità, Figure Rocks li considera misurazioni riportate dal fornitore a meno che non siano disponibili prove indipendenti. Il supporto del prodotto, l'adozione nei giochi e il comportamento del runtime possono cambiare con l'evolversi di SDK, driver e integrazioni nei giochi.
Related Articles
Funzionalità di latenza spiegate: Reflex, Anti-Lag e quando sono effettivamente utili
Le funzionalità di latenza aiutano solo quando la base è stabile. Scopri cosa fanno le funzionalità di tipo Reflex/Anti-Lag, quando riducono il ritardo della coda e quando causano instabilità.
Risolvi l'input lag velocemente (PC & Console): La checklist senza placebo
Smetti di inseguire i miti. Questa checklist affronta le reali cause della sensazione di pesantezza: elaborazione del display, pacing instabile, buffering della coda di rendering e picchi in background.
Catena audio per il gaming: un livello pulito alla volta (niente sovrapposizioni)
Se la percezione della direzione sembra errata, probabilmente stai sovrapponendo le elaborazioni. Questa guida mostra una catena audio pulita e la regola del singolo livello che ripristina la leggibilità dei passi.
Miti del QoS per il gaming: cosa aiuta, cosa danneggia e la vera priorità
La QoS non è un interruttore ‘gaming’ magico. Una buona gestione delle code riduce la latenza sotto carico. Una cattiva QoS aggiunge jitter o rompe l'equità. Ecco il modo corretto di vederla.
Soluzioni per lo stuttering che funzionano davvero: smetti di inseguire tweak grafici casuali
La maggior parte dei ‘fix’ per lo stuttering fallisce perché non corrispondono al tipo di stuttering. Usa questo ordine pratico: triage, riduci i picchi, stabilizza il pacing, poi regola le impostazioni.
Trappole dei 120Hz su console: porta errata, modalità errata e limiti nascosti
I 120Hz spesso non funzionano a causa di semplici discrepanze: porta HDMI errata, modalità di ingresso errata o funzioni disabilitate. Usa questa rapida checklist per ottenere i 120Hz reali.
Ethernet vs Wi-Fi per il Gaming: Quando il Wi-Fi è sufficiente e quando non lo è
Il Wi-Fi può andare bene per il gioco occasionale, ma la stabilità competitiva favorisce ancora l'Ethernet. Usa una semplice checklist decisionale basata su picchi, distanza e carico.
Streaming Stutter: Archiviazione, decompressione e il pattern degli intoppi
Lo stuttering da streaming è il caricamento degli asset: nuove aree, nuove texture, scatti periodici. Impara a riconoscere il pattern, cosa cambiare per primo e quali upgrade aiutano davvero.
Catena della latenza spiegata: da dove proviene realmente il ritardo (End to End)
L'input lag è una catena, non una singola impostazione. Scopri da dove proviene il ritardo (dispositivo, coda di rendering, display) e l'ordine di correzione che migliora effettivamente la sensazione.
Diagnosi dello sfarfallio VRR: perché accade e l'ordine di risoluzione stabile
Lo sfarfallio VRR è solitamente un problema di stabilità, non un display guasto. Scopri perché accade (limiti dell'intervallo, variazioni di luminanza) e l'ordine di risoluzione che funziona davvero.
V-Sync e Tearing: quando aiuta, quando nuoce e l'alternativa stabile
Il tearing è visibile, ma la soluzione sbagliata può aggiungere una sensazione di pesantezza. Scopri quando il V-Sync vale la pena, quando è dannoso e come VRR + cap riducono il tearing con meno compromessi.
Rendi meno, deduci di più: l'IA sta rompendo il tradizionale ciclo di aggiornamento dell'hardware per il gaming?
L'IA sta rendendo il silicio e la memoria ad alte prestazioni più preziosi al di fuori del gaming, offrendo al contempo ai giochi nuovi modi per eseguire il rendering, comprimere e prevedere. Questa analisi si chiede se queste due tendenze stiano convergendo in un nuovo modello hardware.