
NVIDIA RTX Spark pone DLSS 5 y personajes de IA locales en la misma plataforma de juegos
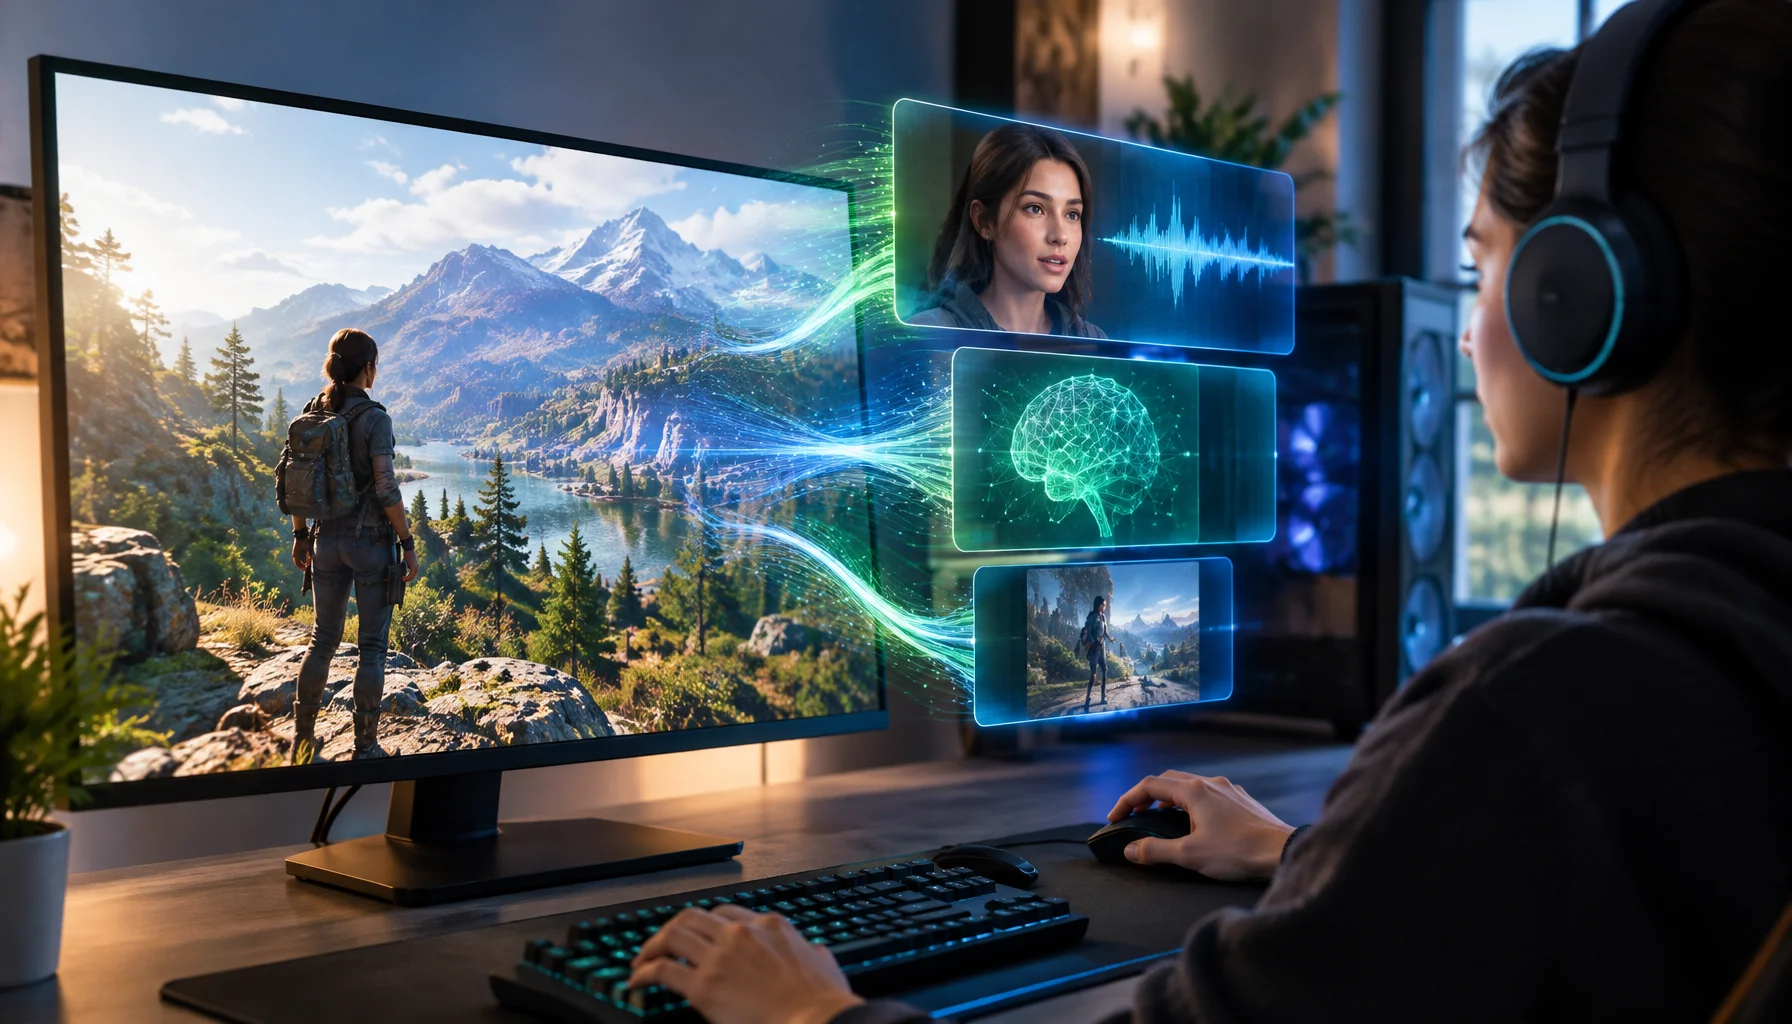
El 27 de octubre de 2026, NVIDIA posicionó RTX Spark como algo más que una nueva plataforma de PC con Windows. La compañía está llevando dos tipos diferentes de carga de trabajo de IA a la misma máquina de juegos: renderizado neuronal mediante DLSS 5 e inteligencia de personajes local mediante NVIDIA ACE y Nemotron 3.5 Bolt E4B 4GB.
Esa combinación es la verdadera noticia. Los juegos están empezando a usar IA local no solo para reconstruir o generar píxeles, sino también para interpretar la intención del jugador, razonar sobre el estado del juego, llamar herramientas y dirigir el comportamiento de los personajes. El desafío técnico ya no es solo si un modelo puede ejecutarse. Es si los gráficos, el habla y la inferencia de agentes pueden compartir memoria, cómputo y presupuestos de latencia sin dañar el juego en sí.
Respuesta directa
RTX Spark es la nueva plataforma de PC con Windows de NVIDIA para desarrollo de IA, creación y juegos, construida en torno a una GPU Blackwell RTX y una CPU Grace con hasta 128 GB de memoria unificada. Para juegos, NVIDIA está combinando esa plataforma con DLSS 5, RTX Kit, soporte para Unreal Engine 5.8 y un nuevo modelo de lenguaje pequeño, Nemotron 3.5 Bolt E4B 4GB, diseñado para personajes de IA locales.
El cambio arquitectónico más importante es que los gráficos neuronales y el razonamiento de agentes de juego se están convirtiendo en cargas de trabajo concurrentes. Un juego futuro podría usar una ruta de IA para mejorar la imagen renderizada mientras otro modelo escucha al jugador, lee el estado relevante, razona sobre una solicitud y selecciona una acción de juego permitida.
Lo que NVIDIA anunció el 27 de octubre de 2026
NVIDIA afirma que RTX Spark combina hasta 128 GB de memoria unificada con la pila de software CUDA, trazado de rayos y la suite completa de DLSS. La pila de juegos también incluye tecnologías RTX Kit, herramientas de desarrollo Nsight, una rama RTX de Unreal Engine 5.8 y el SDK de Inferencia en el Juego usado para ejecutar modelos locales de lenguaje y habla.
La actualización del lado de los personajes se centra en Nemotron 3.5 Bolt E4B 4GB. NVIDIA lanzó el modelo el 23 de octubre y luego destacó su papel en los juegos cuatro días después. El modelo está disponible para desarrolladores a través del SDK de Inferencia en el Juego y está optimizado para agentes conversacionales que necesitan ejecutarse localmente mientras dejan recursos disponibles para el resto de la aplicación.
En el lado del renderizado, DLSS 5 con Renderizado Neuronal Guiado por 3D es compatible con RTX Spark, comenzando con NBA 2K27. NVIDIA afirma que su actualización del modelo DLSS 5 de octubre se ejecuta el doble de rápido que la versión de septiembre, reduce a la mitad la sobrecarga de la GPU y usa un 20% menos de VRAM a 4K mientras mantiene una fidelidad visual comparable. Esas son mediciones de NVIDIA y deben tratarse como afirmaciones de rendimiento del fabricante hasta que se prueben de forma independiente.
El verdadero cambio: la PC de juegos se convierte en un entorno de ejecución de IA compartido
La IA local para juegos tiene una restricción más difícil que un chatbot de escritorio: no es dueña de la máquina. El juego ya está consumiendo tiempo de GPU, ancho de banda de memoria, VRAM o memoria unificada, tiempo de CPU, ancho de banda de almacenamiento y presupuesto de tiempo por fotograma. El reconocimiento de voz y la conversión de texto a voz pueden añadir otra capa de competencia.
Eso hace que la eficiencia por gigabyte sea más importante que el tamaño bruto del modelo. NVIDIA describe Nemotron 3.5 Bolt E4B como ajustándose a aproximadamente 4 GB para sus cargas de trabajo objetivo, de modo que la inferencia de personajes locales pueda coexistir con gráficos y otros modelos. El objetivo de diseño, por lo tanto, no es simplemente un NPC más inteligente. Es un modelo que puede seguir siendo útil mientras el juego aún se está renderizando.
Esto también explica por qué RTX Spark importa como una historia de plataforma en lugar de como el anuncio de un solo modelo. El renderizado neuronal, el razonamiento del lenguaje, el habla y la lógica de juego tradicional están convergiendo en la misma máquina, pero todavía tienen diferentes requisitos de sincronización y diferente autoridad sobre el juego.
Qué aporta Nemotron 3.5 Bolt a los personajes de juego locales
Nemotron 3.5 Bolt E4B 4GB está diseñado para cargas de trabajo conversacionales y agénticas en lugar de control fotograma a fotograma. NVIDIA enumera el uso autónomo de herramientas de múltiples turnos, la adherencia a instrucciones, el razonamiento configurable y la fundamentación en el estado del juego entre sus capacidades principales.
El modelo admite una ventana de contexto de 64K que puede contener historial de conversación, instrucciones, definiciones de herramientas, información recuperada y estado del juego. También admite 35 idiomas, mientras que NVIDIA afirma que el modelo base fue preentrenado en más de 140 idiomas.
NVIDIA reporta una calidad promedio aproximadamente un 40% superior a la de su modelo anterior en puntos de referencia relevantes seleccionados y hasta aproximadamente un 80% menos de tokens de salida que modelos comparables. Estas cifras describen los resultados de los puntos de referencia de NVIDIA, no una mejora garantizada en la credibilidad de los NPC, la latencia del juego o el ritmo de fotogramas.
También hay una distinción importante en la línea de tiempo. El compañero de IA en beta pública de PUBG usa el modelo de lenguaje pequeño Nemotron de primera generación de NVIDIA, mientras que Aniimo demostró un modelo Nemotron de segunda generación. Nemotron 3.5 Bolt es el nuevo modelo para desarrolladores anunciado ahora; NVIDIA no ha dicho que esas implementaciones existentes ya hayan migrado a él.
Figure Rocks ya examinó esa separación en PUBG Ally Shows Why AI Teammates Need Two Brains: el razonamiento del lenguaje es útil para la planificación, la coordinación y la interpretación, mientras que las reacciones rápidas de combate siguen perteneciendo a sistemas deterministas o especializados del lado del juego.
Contexto de 64K, recuperación, estado en vivo y herramientas no son lo mismo
Una ventana de contexto de 64K aumenta la cantidad de información que un modelo puede considerar a la vez, pero no hace automáticamente que el personaje sea conocedor, actual o correcto. La capacidad de contexto responde a cuánta información se puede suministrar. La recuperación decide qué conocimiento externo debe suministrarse. El estado en vivo del juego describe lo que es verdadero en la sesión actual. Las herramientas definen qué se le permite inspeccionar o hacer al agente.
El SDK ACE Game Agent de NVIDIA refleja esa separación directamente. Su API Agent gestiona el razonamiento con estado, de varios pasos y asistido por herramientas; su API Chat brinda a los desarrolladores un control de nivel inferior sobre la inferencia; y su API RAG admite recuperación semántica, léxica e híbrida desde bases de datos creadas por el desarrollador. NVIDIA ya ha demostrado esa arquitectura de recuperación en el asesor experimental de Total War: PHARAOH, que consulta más de 1200 tablas de datos de juego interconectadas.
Para un personaje de juego, esas capas deben mantenerse distintas. Una base de datos de conocimiento puede decir cómo funciona un objeto. El estado actual del juego debe decir si el objeto está realmente presente. El modelo puede decidir que usar el objeto es sensato. Una función validada del lado del juego aún debe decidir si esa acción es legal y ejecutarla.
La inferencia local tampoco significa que todo el juego se vuelva sin conexión. El modelo de lenguaje puede ejecutarse en la máquina del jugador mientras los servidores multijugador, los sistemas de cuentas, el contenido descargable u otros servicios aún requieren una conexión de red.
DLSS 5 convierte la misma máquina en una plataforma de renderizado con IA
DLSS 5 introduce el renderizado neuronal guiado por 3D como otra etapa en la canalización de gráficos. NVIDIA lo describe como una mejora del detalle de iluminación y materiales a partir del fotograma renderizado por el motor, preservando los controles del desarrollador sobre lo que puede cambiar. La geometría, las texturas, los búferes de iluminación y la escena creada existentes siguen siendo la base.
Esa distinción importa porque el renderizado neuronal no es un reemplazo del motor de juego. Es una capa de inferencia que opera sobre la información que el motor ya proporciona. El mismo principio aparece del lado del agente: un modelo de lenguaje puede interpretar y decidir, pero el motor de juego sigue siendo la autoridad sobre el estado válido y las acciones ejecutables.
La arquitectura más amplia se explora en The Game Engine Is Becoming Part Renderer, Part Scheduler, Part AI System. RTX Spark hace esa convergencia más concreta porque la inferencia de renderizado y la inferencia de agentes ahora se diseñan como cargas de trabajo que deben coexistir en un solo sistema local.
Por qué RTX Spark importa a los desarrolladores de juegos
RTX Spark no es solo un paquete de funciones para el consumidor. NVIDIA está proporcionando una ruta de desarrollo a su alrededor: soporte de Unreal Engine 5.8 para Windows on Arm, herramientas de perfilado Nsight, el SDK In-Game Inferencing y ocho tecnologías RTX Kit que cubren áreas como compresión de texturas neuronales, sombreadores neuronales, geometría, eliminación de ruido, renderizado de personajes e iluminación global.
La implicación práctica es que los desarrolladores pueden perfilar cada vez más los gráficos y la IA local como partes de un único presupuesto de tiempo de ejecución, en lugar de tratar la IA como un servicio remoto con supuestos separados de latencia y costo. Eso crea nuevas posibilidades, pero también hace que la programación, la presión de memoria y el comportamiento del tiempo de fotograma en el peor caso sean más importantes.
Lo que los jugadores aún no deben asumir
El soporte de RTX Spark no significa que todos los juegos de repente contendrán personajes de IA sin guion. Los desarrolladores todavía tienen que diseñar el personaje, exponer observaciones y acciones seguras, integrar la interacción por voz o texto, definir el comportamiento de la memoria y decidir cuándo la inferencia del modelo vale el costo de tiempo de ejecución.
Las afirmaciones de rendimiento de DLSS 5 tampoco prueban que todos los juegos compatibles se sientan más receptivos. Las tasas de fotogramas mostradas más altas, los fotogramas generados, la calidad de la reconstrucción neuronal y la latencia de entrada son mediciones relacionadas pero separadas. Una función gráfica puede mejorar la suavidad visual sin reducir cada componente de la latencia de extremo a extremo.
Del mismo modo, un modelo de lenguaje local más potente no hace que el comportamiento del juego sea determinista. El diálogo y el razonamiento abiertos pueden mejorar la adaptabilidad, pero los sistemas con guion siguen siendo más fáciles de probar y más predecibles para comportamientos en los que la respuesta correcta ya se conoce.
Qué está confirmado, qué es una afirmación del fabricante y qué sigue siendo desconocido
Confirmado por NVIDIA: RTX Spark es una plataforma de PC con Windows construida en torno a gráficos Blackwell RTX y CPU Grace; los sistemas pueden proporcionar hasta 128 GB de memoria unificada; se admiten DLSS 5 y la pila de juegos RTX; Nemotron 3.5 Bolt E4B 4GB está disponible para desarrolladores; el modelo admite contexto de 64K, uso de herramientas, razonamiento configurable y fundamentación del estado del juego.
Afirmaciones de rendimiento del fabricante: NVIDIA reporta una calidad promedio aproximadamente un 40% superior a la de su modelo anterior en benchmarks seleccionados, hasta aproximadamente un 80% menos de tokens de salida en comparación con sus pares, y un modelo DLSS 5 de octubre que se ejecuta el doble de rápido que la versión de septiembre mientras reduce a la mitad la sobrecarga de GPU y disminuye en un 20% el uso de VRAM en 4K.
Aún desconocido en este anuncio: el impacto real en el tiempo de fotograma de la renderización, el habla y la inferencia de personajes simultáneas en diferentes sistemas RTX Spark; las mediciones independientes de la latencia de respuesta de los NPC bajo carga de juego; cuántos juegos comerciales adoptarán Nemotron 3.5 Bolt; y cómo equilibrarán los desarrolladores la calidad de la IA local frente a la jugabilidad determinista y los requisitos de hardware.
La opinión de Figure Rocks
La parte más importante del anuncio de NVIDIA del 27 de octubre no es un benchmark ni una demostración de NPC con IA. Es la idea emergente de la PC de juegos como un entorno de ejecución de IA compartido. Los gráficos neuronales, el habla, la recuperación, el razonamiento y la lógica del juego compiten y cooperan cada vez más dentro del mismo margen de tiempo de fotograma y memoria.
Si esa arquitectura funciona bajo carga real, los personajes de IA locales podrían depender menos de los viajes de ida y vuelta a la nube y estar más estrechamente conectados al estado del juego en vivo, mientras la renderización neuronal sigue consumiendo cómputo de IA para la propia imagen. Eso es un cambio significativo en cómo se construyen los juegos: la pregunta pasa de si un juego usa IA a qué cargas de trabajo de IA merecen recursos locales, cuándo deben ejecutarse y qué autoridad recibe cada una.
Fuentes primarias y alcance
Este artículo se basa principalmente en el anuncio de juegos RTX Spark de NVIDIA del 27 de octubre de 2026, la versión de investigación Nemotron 3.5 Bolt E4B 4GB publicada el 23 de octubre, y la documentación y ejemplos del SDK ACE Game Agent de NVIDIA.
Cuando NVIDIA proporciona cifras de rendimiento o calidad, Figure Rocks las trata como mediciones reportadas por el fabricante a menos que haya evidencia independiente disponible. El soporte del producto, la adopción en juegos y el comportamiento en tiempo de ejecución pueden cambiar a medida que evolucionan los SDK, los controladores y las integraciones de juegos.
Related Articles
Renderiza menos, infiere más: ¿Está la IA rompiendo el ciclo tradicional de actualización de hardware para videojuegos?
La IA está haciendo que el silicio y la memoria de alto rendimiento sean más valiosos fuera de los videojuegos, al tiempo que brinda a los juegos nuevas formas de renderizar, comprimir y predecir. Este análisis se pregunta si esas dos tendencias están convergiendo en un nuevo modelo de hardware.
Funciones de latencia explicadas: Reflex, Anti-Lag y cuándo ayudan realmente
Las funciones de latencia solo ayudan cuando la línea base es estable. Aprende qué hacen las funciones de tipo Reflex/Anti-Lag, cuándo reducen el retraso de la cola y cuándo causan inestabilidad.
¿Y si un juego pudiera predecir su próximo acceso a memoria? La precarga con IA y el futuro del stutter
Los motores de juego ya saben hacia dónde van el jugador, la cámara y el mundo. La investigación muestra que la precarga aprendida en la GPU puede predecir páginas de memoria. ¿Qué sucede si se combinan esas ideas?
Selección de canales Wi-Fi para gaming: Reglas sencillas para 2,4 GHz, 5 GHz y 6 GHz
Una mala elección de canal causa picos y pérdida de paquetes. Usa estas reglas sencillas para elegir una banda más limpia y reducir la interferencia antes de comprar hardware.
Lista de verificación del router para gaming: Los 10 ajustes que realmente importan
La mayoría de los ajustes del router son ruido. Usa esta lista de verificación para enfocarte en la estabilidad bajo carga: entorno Wi-Fi, gestión de colas y valores predeterminados sensatos que reduzcan los picos.
Cadena de input lag a fondo: Dónde se acumula realmente el retraso (Click-to-Photon)
El input lag es una cadena: dispositivo, SO, bucle de juego, cola de renderizado, pantalla. Aprende dónde se acumula el retraso y cómo reducirlo estabilizando los tiempos y eliminando el procesamiento oculto.
Eliminadores de carga en segundo plano: La lista de verificación de PC que detiene la sensación de pesadez aleatoria
Si el mismo juego se siente genial un día y pesado al siguiente, sospecha de la carga en segundo plano. Esta lista de verificación elimina a los culpables comunes: superposiciones, sincronización, escaneos y picos de programación.
Stuttering por limitación de CPU a fondo: Por qué los FPS pueden verse bien pero sentirse fatal
Los picos de CPU crean tiempos de fotograma desiguales que se sienten como microtirones, apuntado pesado y movimiento inconsistente. Aprende las señales y el orden de corrección que restaura la sensación de estabilidad.
Mitos del modo exclusivo: Cuándo ayuda al audio (Rara vez) y cuándo rompe los juegos
El modo exclusivo puede reducir la mezcla del SO, pero a menudo crea conflictos e inestabilidad. Úsalo solo cuando mejore la consistencia, no porque suene ‘pro’.
Hub de amiibo: Empieza aquí (Pilares, guías y qué comprar primero)
Tu biblioteca de Amiibo en un solo lugar: conceptos básicos, compatibilidad, compra y coleccionismo. Usa este centro para elegir tu camino y evitar errores de principiante.
Shader Stutter: Por qué las primeras ejecuciones dan tirones y cómo reducirlo.
El stuttering de shaders ocurre cuando los nuevos efectos se compilan en tiempo real. Aprende a identificarlo rápido y las formas prácticas de reducir los tirones sin ajustes placebo.
Nivel de negro HDMI y rango RGB: La solución rápida para imágenes lavadas o empastadas
Los negros lavados o el detalle de sombras perdido suelen ser un desajuste de rango, no una pantalla defectuosa. Usa esta comprobación rápida para corregir la legibilidad en minutos.