
La compresión de texturas neuronales RTX no es escalado: cómo la IA puede intercambiar memoria de texturas por cómputo de GPU
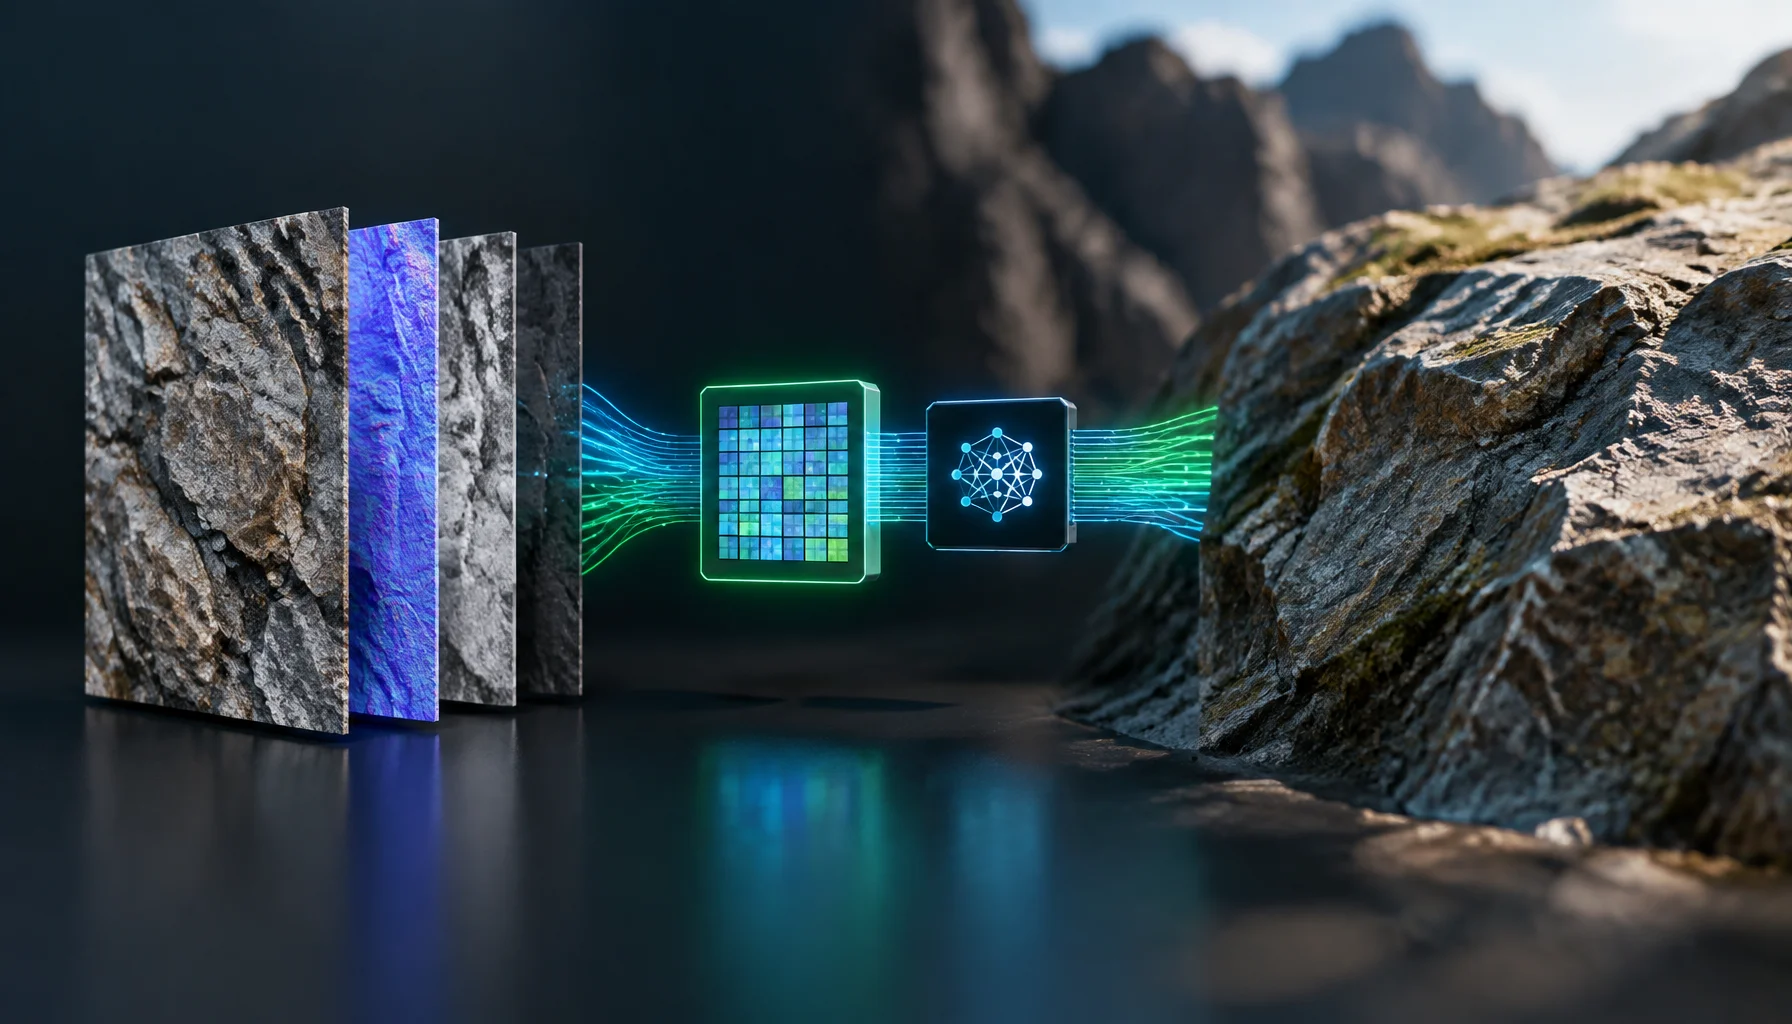
La compresión de texturas normalmente significa almacenar una versión más pequeña de los datos de textura y expandirla a un formato de GPU convencional antes o durante su uso. NVIDIA RTX Neural Texture Compression cambia ese modelo: parte de los datos de textura se convierte en una pequeña representación neuronal que puede ser decodificada por la propia GPU.
Por qué la compresión de texturas normal sigue usando mucha memoria
Un material moderno basado en física rara vez consiste en una sola imagen. Una única superficie puede usar albedo, normal, rugosidad, metalicidad, oclusión ambiental, opacidad y otros canales.
Los formatos tradicionales de compresión de bloques para GPU, como BC1 a BC7, reducen el coste, pero la GPU sigue almacenando bloques de textura convencionales para el material.
A medida que aumentan la resolución de textura y la complejidad del material, esos canales consumen espacio en disco, ancho de banda de streaming y memoria de GPU.
Qué almacena realmente RTX Neural Texture Compression
El SDK RTXNTC de NVIDIA comprime juntos los canales que pertenecen a un material. El SDK actual admite hasta 16 canales de textura en un conjunto de texturas NTC.
En lugar de conservar solo texeles comprimidos convencionales, el proceso de compresión produce dos cosas principales: pesos para un pequeño decodificador neuronal y datos de características latentes compactos.
El pipeline de texturas neuronales
Por qué comprimir canales juntos puede ayudar
Los canales de material suelen estar relacionados. Un arañazo visible en el color base también puede aparecer en el mapa normal o de rugosidad. Un patrón de tela puede influir en varios canales en la misma ubicación espacial.
NVIDIA diseñó NTC para aprovechar esas correlaciones en lugar de comprimir cada textura de forma independiente.
Esa es una de las razones por las que la tecnología se describe como compresión orientada a materiales en lugar de ser simplemente otro formato de imagen.
Los tres modos de ejecución de NTC son la clave para entender la tecnología
La parte más importante de RTXNTC no es solo cómo se comprime el material. Es cuándo elige el juego descomprimirlo.
Inferencia al cargar vs Inferencia al muestrear vs Inferencia por retroalimentación
| Cuándo ocurre la decodificación neuronal | Comportamiento de la memoria de texturas en tiempo de ejecución | Principal compensación | |
|---|---|---|---|
| Inferencia al cargar | |||
| Inferencia al muestrear | |||
| Inferencia por retroalimentación |
Inferencia al cargar: compresión neuronal como formato de almacenamiento
La Inferencia al cargar es el modo más fácil de entender.
El juego almacena el material en forma NTC compacta. Cuando se carga el recurso, la GPU reconstruye los datos de textura y puede transcodificarlos a formatos de textura BCn ordinarios.
Después de ese paso, el renderizado puede usar muestreo de textura normal. El ahorro importante se produce principalmente antes de la descompresión: tamaño del juego empaquetado, tamaño de descarga o ancho de banda de transmisión de recursos.
Pero una vez que el material se expande completamente a texturas convencionales, su huella de VRAM en tiempo de ejecución se acerca de nuevo a la representación convencional.
Inferencia al muestrear: mantener la textura neuronal en VRAM
La Inferencia al muestrear es el modo más radical.
En lugar de expandir el material a texturas convencionales antes del renderizado, el shader lee datos latentes compactos y ejecuta el decodificador neuronal cuando necesita valores de textura.
El propio ejemplo del SDK de NVIDIA compara una representación de material BCn de 12 MB con una representación NTC de 2.5 MB cuando se usa Inferencia al muestrear.
El ahorro es real porque los datos de textura convencionales no necesitan permanecer completamente residentes. Pero el costo se traslada a otro lugar: el shader de píxeles o de impactos ahora realiza inferencia neuronal.
Inferencia por retroalimentación: decodificar solo lo que el jugador ve realmente
La Inferencia por retroalimentación se sitúa entre los dos extremos.
El renderizador rastrea qué mosaicos de textura se solicitan realmente. En lugar de expandir el material completo de inmediato, el sistema puede decodificar los mosaicos solicitados por lotes y mantener una caché de trabajo.
Conceptualmente, esto combina compresión neuronal con transmisión de texturas: el sistema paga el costo de decodificación solo por las regiones que se vuelven relevantes.
La implementación de ejemplo actual es más especializada que los otros modos y sus restricciones de soporte difieren, por lo que debe tratarse como una estrategia de integración en lugar de un reemplazo universal para la transmisión de texturas ordinaria.
El intercambio entre almacenamiento de texturas y cómputo
La forma más sencilla de entender la compresión de texturas neuronales es como un intercambio entre recursos.
Qué cambia cuando el almacenamiento de texturas se vuelve neuronal
| Textura comprimida tradicional | Representación de textura neuronal | |
|---|---|---|
| Disco/almacenamiento | ||
| VRAM | ||
| Costo de muestreo | ||
| Control de calidad |
Por qué importa el hardware especializado en matrices
Ejecutar una red neuronal para el muestreo de texturas sería demasiado costoso si cada multiplicación tuviera que manejarse como trabajo escalar ordinario de sombreadores.
Por lo tanto, RTXNTC se beneficia de Cooperative Vector y ahora de las rutas de Álgebra Lineal de DirectX 12 que permiten a los sombreadores usar hardware de aceleración de matrices de la GPU.
La beta v0.10.0 añadió explícitamente la inferencia a través de la API de Álgebra Lineal de DirectX 12 introducida con Shader Model 6.10.
Por qué la compresión de texturas neuronales no es escalado de texturas
Ambas técnicas pueden usar aprendizaje automático, pero resuelven problemas diferentes.
Compresión de texturas neuronales vs superresolución
| Compresión de texturas neuronales | Superresolución | |
|---|---|---|
| Entrada | ||
| Objetivo | ||
| Cuándo se ejecuta | ||
| Salida |
Por lo tanto, la compresión de texturas neuronales puede existir por debajo de DLSS, FSR, XeSS o renderizado nativo. Cambia cómo se almacenan y reconstruyen los datos de materiales, no la resolución final de visualización.
El control de calidad son los bits por píxel
NTC es compresión con pérdida. La cantidad de información comprimida se controla en gran medida mediante la configuración de bits por píxel.
Una tasa de bits más alta proporciona más información al modelo y generalmente mejora la calidad de reconstrucción. Una tasa de bits más baja mejora la compresión pero aumenta el riesgo de error visible.
Debido a que múltiples canales comparten la misma representación, añadir más canales de material sin aumentar la tasa de bits puede reducir la calidad disponible para cada canal.
Por qué son importantes los canales de material correlacionados
Una representación neuronal se vuelve más valiosa cuando varios canales de material describen una estructura relacionada.
Si el albedo, la normal y la rugosidad contienen todos los mismos arañazos, costuras o tejido, el decodificador puede explotar la información espacial compartida.
Si los canales son ruido no relacionado, hay menos estructura común que explotar y el problema de compresión se vuelve más difícil.
La prueba de valor de la textura neuronal
¿Cuándo es realmente útil la compresión de texturas neuronales?
Por qué “8× más pequeño” necesita contexto
El RTX Kit de NVIDIA describe la RTX Neural Texture Compression como una tecnología que ofrece hasta 8× de mejora en memoria de disco con una fidelidad visual similar a la compresión de bloques tradicional.
La frase “hasta” importa. La relación de compresión depende del material, el número de canales, el bitrate objetivo, la configuración del decodificador y el umbral de calidad.
La misma relación tampoco describe automáticamente el ahorro de VRAM. La inferencia en carga puede partir de un archivo compacto y aun así expandirse a texturas GPU convencionales. La inferencia en muestreo conserva la representación compacta en la memoria GPU, pero gasta más cómputo durante el sombreado.
El tamaño del decodificador es otro compromiso entre rendimiento y calidad
El runtime de NTC usa un pequeño perceptrón multicapa para decodificar los valores de textura.
La biblioteca actual de NVIDIA usa una arquitectura de decodificador configurable. Las redes más grandes pueden mejorar la calidad de compresión, pero cuestan más de ejecutar; las redes más pequeñas pueden ejecutarse más rápido con cierta pérdida en la calidad de reconstrucción.
Eso da a los desarrolladores de motores otra dimensión de ajuste más allá de la resolución de textura y el bitrate.
Por qué esto importa para futuras instalaciones de juegos
Los juegos modernos incluyen cada vez más conjuntos de materiales de alta resolución que afectan tanto al tamaño de descarga como a la memoria en tiempo de ejecución.
La compresión de texturas neuronales crea una nueva opción: distribuir una representación aprendida compacta y decidir después si expandirla al cargar, reconstruirla directamente durante el sombreado o decodificar solo los tiles solicitados.
Eso significa que una representación de recurso comprimido puede participar en varias estrategias de memoria en tiempo de ejecución diferentes.
También cambia lo que significa 'memoria de textura'
Con la renderización tradicional, un presupuesto de memoria de texturas se basa principalmente en formatos de textura, niveles de mip, resolución y residencia.
Con las texturas neuronales, los desarrolladores también pueden presupuestar datos latentes, pesos del decodificador, búferes de inferencia, cachés transcodificadas y el cómputo necesario para reconstruir los valores solicitados.
Así que el recurso ya no tiene una única identidad de memoria fija y simple.
El soporte entre proveedores es más matizado de lo que sugiere el nombre RTX
RTXNTC es un SDK de NVIDIA, y la compresión en sí actualmente requiere una GPU NVIDIA según los requisitos del SDK.
La descompresión en tiempo de ejecución es más amplia. NVIDIA documenta rutas funcionales en hardware Shader Model 6 y señala validación en GPU NVIDIA, AMD e Intel, mientras que las rutas avanzadas de Cooperative Vector / Linear Algebra dependen del soporte de API y controladores.
Por lo tanto, no se debe asumir paridad de rendimiento y características entre proveedores simplemente porque el decodificador básico pueda ejecutarse.
¿Qué cambiaría esta respuesta?
NTC todavía está en beta. Los modos de tiempo de ejecución, las arquitecturas de decodificador, el soporte de controladores y las rutas de integración pueden cambiar antes de un lanzamiento de producción estable.
El mayor cambio a largo plazo sería la adopción generalizada de primitivas de sombreado neuronal estandarizadas en DirectX y Vulkan. Eso haría que la decodificación de texturas neuronales dependiera menos de rutas de ejecución personalizadas específicas de cada proveedor.
Limitaciones
Este artículo describe la arquitectura y el comportamiento público actual del SDK RTXNTC. Las afirmaciones de compresión citadas por NVIDIA son proporcionadas por el proveedor y no deben tratarse como resultados garantizados para todos los materiales.
El SDK actual es software beta, y algunas rutas de vista previa tienen limitaciones documentadas de controladores y plataforma.
Conclusión
RTX Neural Texture Compression es interesante porque cambia una suposición muy antigua: el detalle de textura no siempre tiene que existir en memoria como texeles convencionales.
En su lugar, un material puede almacenarse parcialmente como una representación aprendida compacta y reconstruirse cuando sea necesario.
Eso no proporciona calidad gratuita ni memoria gratuita. Crea un nuevo intercambio: menos almacenamiento, ancho de banda y potencialmente VRAM a cambio de trabajo de inferencia neuronal.
La verdadera innovación no es "la IA hace que las texturas sean más nítidas". Es que parte de los datos de materiales de un juego pueden convertirse en cómputo.
Preguntas frecuentes
RTX Neural Texture Compression en lenguaje sencillo
¿RTX Neural Texture Compression es un escalador?
¿Puede NTC reducir el uso de VRAM?
¿Qué almacena la red neuronal?
¿NTC decodifica toda la textura antes de renderizar?
¿La compresión neuronal de texturas es sin pérdida?
¿RTXNTC está listo para producción?
Glosario
Términos clave de texturas neuronales
- Neural Texture Compression
- Una técnica que almacena información de textura como datos latentes compactos más pesos de decodificador neuronal en lugar de solo bloques de texeles convencionales.
- Datos latentes
- Características aprendidas compactas que el decodificador neuronal utiliza para reconstruir los valores de textura.
- Decodificador
- Una pequeña red neuronal que convierte las características latentes en canales de textura reconstruidos.
- Inference on Load
- Modo de tiempo de ejecución que decodifica la textura neuronal cuando se carga un recurso, generalmente a formatos de textura convencionales.
- Inference on Sample
- Modo de tiempo de ejecución que realiza la decodificación neuronal directamente durante el muestreo de textura para que la representación comprimida pueda permanecer residente.
- Inference on Feedback
- Estrategia de tiempo de ejecución que utiliza retroalimentación de textura para decodificar y almacenar en caché solo los mosaicos solicitados.
- Intercambio de almacenamiento de texturas por cómputo
- Un modelo de Figure Rocks que describe el intercambio de almacenamiento de texturas, ancho de banda y VRAM por trabajo adicional de inferencia neuronal en la GPU.
- Prueba de valor de textura neuronal
- Un flujo de trabajo de Figure Rocks para decidir si la compresión neuronal de texturas genera un beneficio neto para un material particular y una GPU objetivo.
Fuentes primarias
NVIDIA Developer — RTX KitDescripción general oficial de RTX Neural Texture Compression y el posicionamiento publicado por NVIDIA sobre reducción de almacenamiento.
NVIDIA RTXNTC — SDK READMEDocumentación oficial del SDK que describe la compresión de canales de material, la representación decodificador/latente, los modos de tiempo de ejecución, ejemplos de memoria, requisitos del sistema y soporte de Cooperative Vector.
NVIDIA RTXNTC — VersionesHistorial oficial de versiones, incluida la beta v0.10.0 y el soporte de inferencia de DirectX 12 Linear Algebra.
NVIDIA RTXNTC — Configuración de compresión y calidad de imagenDocumentación oficial que cubre la tasa de bits, las interacciones entre canales, la medición de calidad y el comportamiento de la compresión con pérdida.
NVIDIA — LibNTCDocumentación oficial de la biblioteca de tiempo de ejecución que describe la configuración del decodificador y el equilibrio entre calidad y rendimiento de los diferentes tamaños de red neuronal.
Related Articles
Soluciones para el stuttering de streaming de almacenamiento: Cuando los recursos no pueden seguir el ritmo
Los tirones por streaming ocurren cuando se cargan nuevas áreas: límites de almacenamiento, descompresión o transmisión de activos. Usa este orden de soluciones antes de bajar todos los ajustes gráficos.
amiibo FAQ: Las 20 preguntas que todo el mundo hace (y las respuestas directas)
Una guía de preguntas frecuentes de Amiibo sin rodeos: compatibilidad, escaneo, regiones, reimpresiones, valor y reglas de coleccionismo — respondidas con claridad para que los principiantes dejen de malgastar dinero.
DLSS 5 no es solo escalado: qué cambia realmente la renderización neuronal guiada por 3D
DLSS 5 lleva la IA a una nueva parte de la canalización de gráficos. En lugar de solo reconstruir la resolución o generar fotogramas adicionales, el renderizado neuronal guiado por 3D utiliza el propio fotograma del motor del juego como base y mejora la iluminación y el detalle de los materiales bajo el control del desarrollador.
¿Bajaste la configuración gráfica pero los FPS no mejoraron? Probablemente estés ajustando el cuello de botella equivocado
Reduces las sombras, los efectos y la resolución, pero los FPS apenas cambian. Esta guía explica por qué los ajustes gráficos solo ayudan cuando reducen la carga de trabajo que realmente está limitando el fotograma, y cómo identificar los cuellos de botella de CPU, GPU, memoria, streaming y límite de fotogramas.
Almacenamiento y streaming: reduce los tiempos de carga sin generar tirones
El almacenamiento rápido solo ayuda cuando el comportamiento de la transmisión es estable. Esta guía explica cómo las E/S afectan a los tirones y qué cambiar primero.
DirectStorage 1.4 no hace que tu SSD descomprima juegos: qué hacen realmente Zstd y la descompresión por GPU
DirectStorage 1.4 añade compresión Zstandard, descompresión por GPU y una nueva Game Asset Conditioning Library, pero el SSD en sí sigue siendo solo una parte de la canalización de carga. Esta guía explica qué hacen realmente el SSD, DirectStorage, la CPU, la GPU y el motor del juego.
El uso de VRAM no es un requisito de VRAM: por qué un medidor de memoria lleno no cuenta toda la historia
Ver 7,8 GB usados en una tarjeta gráfica de 8 GB puede parecer una prueba de que un juego se ha quedado sin VRAM. No es tan sencillo. Esta guía explica la capacidad de VRAM, los presupuestos de residencia, los conjuntos de trabajo, la memoria compartida y cómo determinar si la presión de memoria está causando realmente tirones.
Windows Auto SR no es DLSS: cómo funciona el escalado por NPU sin integración en el juego
Windows Auto SR puede reescalar juegos compatibles sin integración de DLSS, FSR o XeSS. En lugar de ejecutar el modelo de reconstrucción dentro del juego en la GPU, Windows utiliza la NPU para reconstruir una imagen de mayor resolución a partir de un renderizado de menor resolución.