
La compression de textures neuronale RTX n'est pas de la mise à l'échelle : comment l'IA peut échanger de la mémoire de textures contre de la puissance de calcul GPU
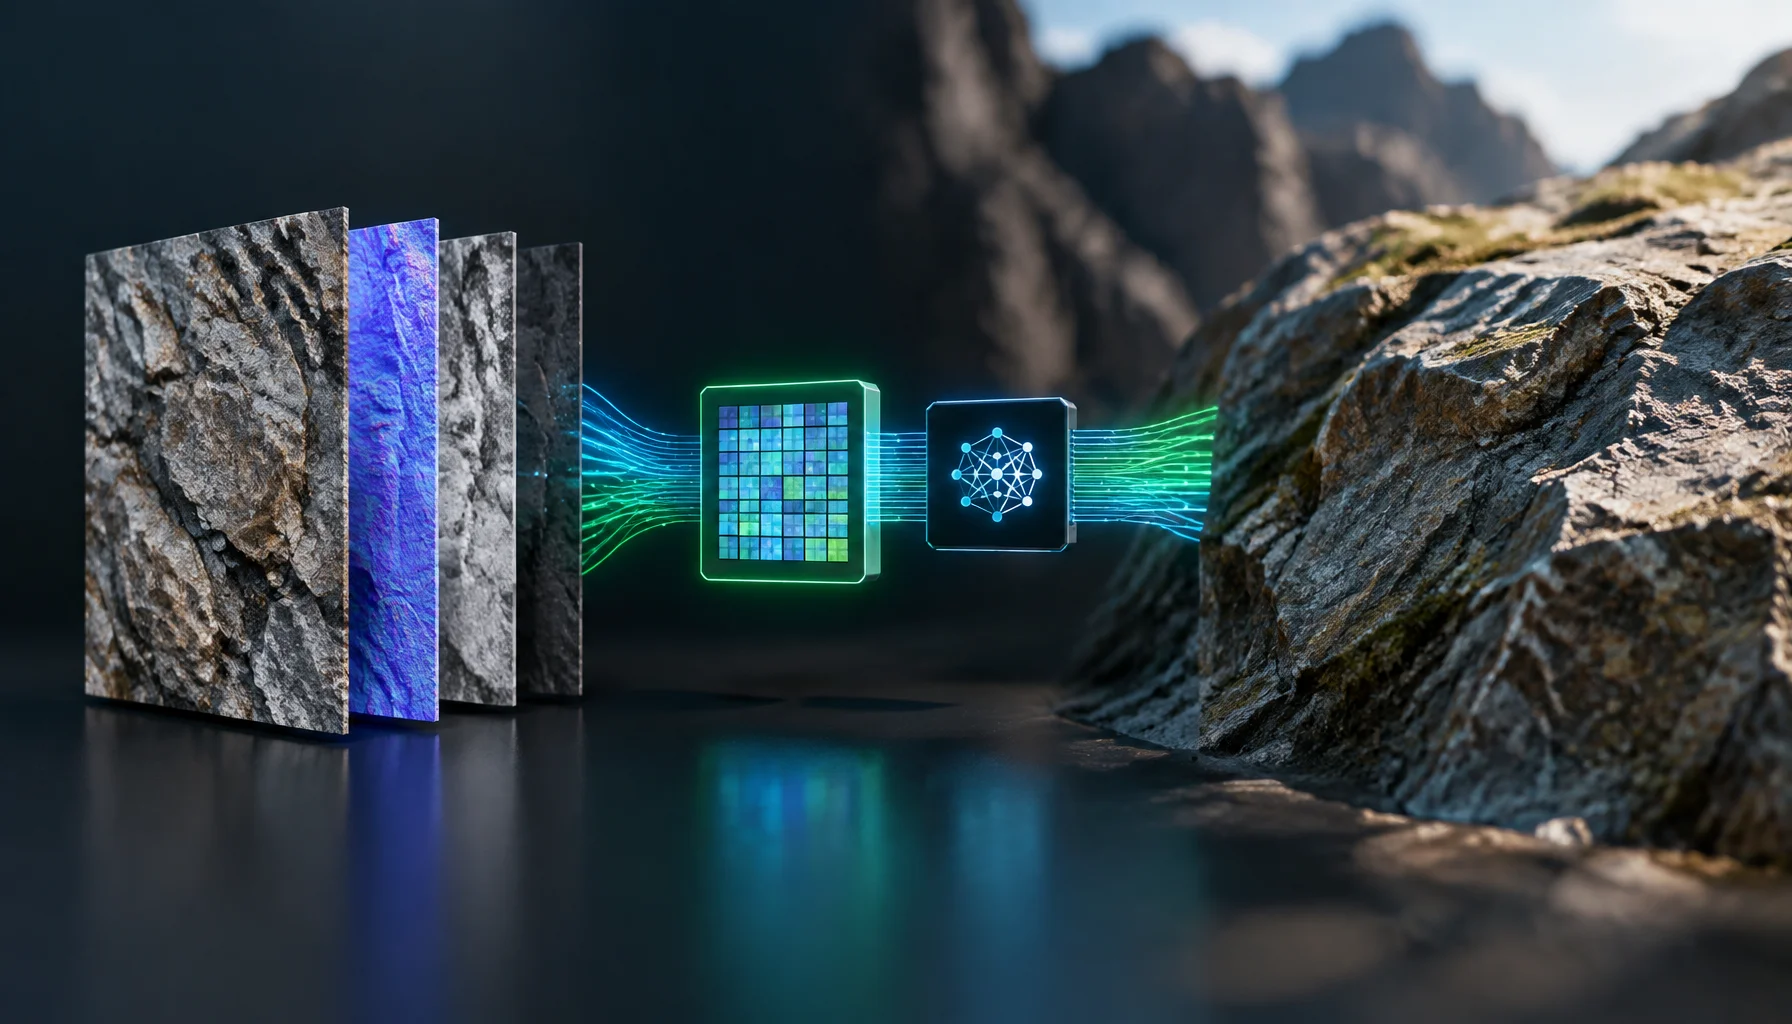
La compression de texture signifie normalement stocker une version plus petite des données de texture et la développer dans un format GPU conventionnel avant ou pendant l'utilisation. NVIDIA RTX Neural Texture Compression change ce modèle : une partie des données de texture devient une petite représentation neuronale qui peut être décodée par le GPU lui-même.
Pourquoi la compression de texture normale utilise encore beaucoup de mémoire
Un matériau moderne basé sur la physique se compose rarement d'une seule image. Une seule surface peut utiliser l'albédo, la normale, la rugosité, la métallicité, l'occlusion ambiante, l'opacité et d'autres canaux.
Les formats de compression de blocs GPU traditionnels tels que BC1 à BC7 réduisent le coût, mais le GPU finit toujours par stocker des blocs de texture conventionnels pour le matériau.
À mesure que la résolution des textures et la complexité des matériaux augmentent, ces canaux consomment de l'espace disque, de la bande passante de streaming et de la mémoire GPU.
Ce que RTX Neural Texture Compression stocke réellement
Le SDK RTXNTC de NVIDIA compresse ensemble les canaux appartenant à un même matériau. Le SDK actuel prend en charge jusqu'à 16 canaux de texture dans un ensemble de textures NTC.
Au lieu de conserver uniquement des texels compressés conventionnels, le processus de compression produit deux éléments principaux : les poids d'un petit décodeur neuronal et des données de caractéristiques latentes compactes.
Le pipeline de texture neuronale
Pourquoi compresser les canaux ensemble peut aider
Les canaux de matériau sont souvent liés. Une rayure visible dans la couleur de base peut également apparaître dans la carte de normale ou de rugosité. Un motif de tissu peut influencer plusieurs canaux au même emplacement spatial.
NVIDIA a conçu NTC pour exploiter ces corrélations au lieu de compresser chaque texture indépendamment.
C'est l'une des raisons pour lesquelles la technologie est décrite comme une compression orientée matériau plutôt que simplement un autre format d'image.
Les trois modes d'exécution NTC sont la clé pour comprendre la technologie
La partie la plus importante de RTXNTC n'est pas seulement la façon dont le matériau est compressé. C'est le moment où le jeu choisit de le décompresser.
Inférence au chargement vs Inférence à l'échantillonnage vs Inférence sur retour
| Quand le décodage neuronal a lieu | Comportement de la mémoire de textures à l'exécution | Principal compromis | |
|---|---|---|---|
| Inférence au chargement | |||
| Inférence à l'échantillonnage | |||
| Inférence sur retour |
Inférence au chargement : la compression neuronale comme format de stockage
L'inférence au chargement est le mode le plus simple à comprendre.
Le jeu stocke le matériau sous forme NTC compacte. Lorsque l'actif est chargé, le GPU reconstruit les données de texture et peut les transcoder dans des formats de texture BCn ordinaires.
Après cette étape, le rendu peut utiliser l'échantillonnage de texture normal. L'économie importante se situe principalement avant la décompression : taille du jeu empaqueté, taille du téléchargement ou bande passante de streaming des actifs.
Mais une fois le matériau entièrement décompressé en textures conventionnelles, son empreinte VRAM à l'exécution se rapproche à nouveau de la représentation conventionnelle.
Inférence à l'échantillonnage : garder la texture neuronale en VRAM
L'inférence à l'échantillonnage est le mode le plus radical.
Au lieu de décompresser le matériau en textures conventionnelles avant le rendu, le shader lit des données latentes compactes et exécute le décodeur neuronal lorsqu'il a besoin de valeurs de texture.
L'exemple du SDK de NVIDIA compare une représentation de matériau BCn de 12 Mo à une représentation NTC de 2,5 Mo lors de l'utilisation de l'inférence à l'échantillonnage.
L'économie est réelle car les données de texture conventionnelles n'ont pas besoin de rester entièrement résidentes. Mais le coût se déplace ailleurs : le shader de pixels ou de collision effectue désormais l'inférence neuronale.
Inférence sur retour : ne décoder que ce que le joueur voit réellement
L'inférence sur retour se situe entre les deux extrêmes.
Le moteur de rendu suit les tuiles de texture réellement demandées. Au lieu de décompresser immédiatement tout le matériau, le système peut décoder les tuiles demandées par lots et conserver un cache de travail.
Conceptuellement, cela combine la compression neuronale avec le streaming de textures : le système ne paie le coût de décodage que pour les régions qui deviennent pertinentes.
L'implémentation actuelle de l'exemple est plus spécialisée que les autres modes et ses contraintes de prise en charge diffèrent, elle doit donc être traitée comme une stratégie d'intégration plutôt que comme un remplacement universel du streaming de textures ordinaire.
L'échange stockage-calcul des textures
La façon la plus simple de comprendre la compression neuronale de textures est de la voir comme un échange entre ressources.
Ce qui change lorsque le stockage des textures devient neuronal
| Texture compressée traditionnelle | Représentation neuronale de texture | |
|---|---|---|
| Disque/stockage | ||
| VRAM | ||
| Coût d'échantillonnage | ||
| Contrôle de qualité |
Pourquoi le matériel matriciel spécialisé est important
Exécuter un réseau de neurones pour l'échantillonnage de textures serait trop coûteux si chaque multiplication devait être traitée comme un simple calcul scalaire de shader.
RTXNTC bénéficie donc de Cooperative Vector et désormais des chemins DirectX 12 Linear Algebra qui permettent aux shaders d'utiliser le matériel d'accélération matricielle du GPU.
La bêta v0.10.0 a explicitement ajouté l'inférence via l'API DirectX 12 Linear Algebra introduite avec Shader Model 6.10.
Pourquoi la compression neuronale de textures n'est pas de la mise à l'échelle de textures
Les deux techniques peuvent toutes deux utiliser l'apprentissage automatique, mais elles résolvent des problèmes différents.
Compression neuronale de textures vs Super Résolution
| Compression neuronale de textures | Super Résolution | |
|---|---|---|
| Entrée | ||
| Objectif | ||
| Quand elle s'exécute | ||
| Sortie |
La compression neuronale de textures peut donc exister sous DLSS, FSR, XeSS ou le rendu natif. Elle modifie la façon dont les données de matériau sont stockées et reconstruites, pas la résolution d'affichage finale.
Le réglage de qualité est le nombre de bits par pixel
NTC est une compression avec perte. La quantité d'informations compressées est contrôlée en grande partie par le réglage des bits par pixel.
Un débit binaire plus élevé donne plus d'informations au modèle et améliore généralement la qualité de reconstruction. Un débit binaire plus faible améliore la compression mais augmente le risque d'erreurs visibles.
Comme plusieurs canaux partagent la même représentation, ajouter davantage de canaux de matériau sans augmenter le débit binaire peut réduire la qualité disponible pour chaque canal.
Pourquoi les canaux de matériau corrélés sont importants
Une représentation neuronale devient plus précieuse lorsque plusieurs canaux de matière décrivent une structure apparentée.
Si l'albédo, la normale et la rugosité contiennent tous les mêmes rayures, coutures ou tissage, le décodeur peut exploiter des informations spatiales partagées.
Si les canaux sont du bruit non corrélé, il y a moins de structure commune à exploiter et le problème de compression devient plus difficile.
Le test de valeur des textures neuronales
Quand la compression de textures neuronale est-elle réellement utile ?
Pourquoi « 8× plus petit » nécessite du contexte
Le RTX Kit de NVIDIA décrit la RTX Neural Texture Compression comme offrant jusqu'à 8× d'amélioration de la mémoire disque à une fidélité visuelle similaire à la compression par blocs traditionnelle.
L'expression « jusqu'à » compte. Le taux de compression dépend de la matière, du nombre de canaux, du débit binaire cible, de la configuration du décodeur et du seuil de qualité.
Le même taux ne décrit pas non plus automatiquement les économies de VRAM. L'inférence au chargement peut partir d'un fichier compact et s'étendre ensuite en textures GPU conventionnelles. L'inférence à l'échantillonnage préserve la représentation compacte en mémoire GPU mais dépense plus de calcul pendant l'ombrage.
La taille du décodeur est un autre compromis performance-qualité
L'environnement d'exécution NTC utilise un petit perceptron multicouche pour décoder les valeurs de texture.
La bibliothèque actuelle de NVIDIA utilise une architecture de décodeur configurable. Des réseaux plus grands peuvent améliorer la qualité de compression mais coûtent plus cher à exécuter ; des réseaux plus petits peuvent s'exécuter plus rapidement avec une certaine perte de qualité de reconstruction.
Cela donne aux développeurs de moteurs une dimension de réglage supplémentaire au-delà de la résolution de texture et du débit binaire.
Pourquoi cela compte pour les futures installations de jeux
Les jeux modernes livrent de plus en plus d'ensembles de matières haute résolution qui affectent la taille de téléchargement ainsi que la mémoire d'exécution.
La compression de textures neuronale crée une nouvelle option : livrer une représentation apprise compacte et décider plus tard de l'étendre au chargement, de la reconstruire directement pendant l'ombrage ou de ne décoder que les tuiles demandées.
Cela signifie qu'une seule représentation d'actif compressé peut participer à plusieurs stratégies de mémoire d'exécution différentes.
Cela change aussi ce que signifie « mémoire de texture »
Avec le rendu traditionnel, un budget de mémoire de textures concerne principalement les formats de textures, les niveaux de mip, la résolution et la résidence.
Avec les textures neuronales, les développeurs peuvent également budgétiser les données latentes, les poids du décodeur, les tampons d'inférence, les caches transcodés et la puissance de calcul nécessaire pour reconstruire les valeurs demandées.
Ainsi, l'actif n'a plus une seule identité mémoire fixe et simple.
La prise en charge multi-fournisseurs est plus nuancée que ne le suggère le nom RTX
RTXNTC est un SDK NVIDIA, et la compression elle-même nécessite actuellement un GPU NVIDIA selon les exigences du SDK.
La décompression à l'exécution est plus large. NVIDIA documente des chemins fonctionnels sur le matériel Shader Model 6 et note une validation sur les GPU NVIDIA, AMD et Intel, tandis que les chemins avancés Cooperative Vector / Linear Algebra dépendent de la prise en charge des API et des pilotes.
La performance et la parité des fonctionnalités ne doivent donc pas être supposées entre les fournisseurs simplement parce que le décodeur de base peut s'exécuter.
Qu'est-ce qui changerait cette réponse ?
NTC est encore en version bêta. Les modes d'exécution, les architectures de décodeur, la prise en charge des pilotes et les chemins d'intégration peuvent changer avant une version de production stable.
Le changement le plus important à long terme serait l'adoption généralisée de primitives de shaders neuronaux standardisées dans DirectX et Vulkan. Cela rendrait le décodage de textures neuronales moins dépendant de chemins d'exécution personnalisés propres à un fournisseur.
Limitations
Cet article décrit l'architecture et le comportement actuel du SDK RTXNTC public. Les affirmations de compression citées par NVIDIA sont fournies par le fournisseur et ne doivent pas être considérées comme des résultats garantis pour chaque matériau.
Le SDK actuel est un logiciel bêta, et certains chemins de prévisualisation ont des limitations documentées de pilote et de plateforme.
Conclusion
RTX Neural Texture Compression est intéressant car il change une hypothèse très ancienne : le détail des textures ne doit pas toujours exister en mémoire sous forme de texels conventionnels.
Un matériau peut plutôt être stocké en partie sous forme de représentation apprise compacte et reconstruit lorsque nécessaire.
Cela ne donne pas une qualité gratuite ni de la mémoire gratuite. Cela crée un nouvel échange : moins de stockage, de bande passante et potentiellement de VRAM en échange d'un travail d'inférence neuronale.
La véritable innovation n'est pas « l'IA rend les textures plus nettes ». C'est qu'une partie des données de matériaux d'un jeu peut devenir du calcul.
FAQ
La compression de textures neuronale RTX expliquée simplement
La compression de textures neuronale RTX est-elle un upscaler ?
NTC peut-il réduire l'utilisation de la VRAM ?
Que stocke le réseau de neurones ?
NTC décode-t-il toute la texture avant le rendu ?
La compression de textures neuronale est-elle sans perte ?
RTXNTC est-il prêt pour la production ?
Glossaire
Termes clés des textures neuronales
- Compression de textures neuronale
- Une technique qui stocke les informations de texture sous forme de données latentes compactes plus les poids du décodeur neuronal au lieu de seulement des blocs de texels conventionnels.
- Données latentes
- Caractéristiques apprises compactes que le décodeur neuronal utilise pour reconstruire les valeurs de texture.
- Décodeur
- Un petit réseau de neurones qui convertit les caractéristiques latentes en canaux de texture reconstruits.
- Inférence au chargement
- Mode d'exécution qui décode la texture neuronale lors du chargement d'un actif, généralement vers des formats de texture conventionnels.
- Inférence à l'échantillonnage
- Mode d'exécution qui effectue le décodage neuronal directement pendant l'échantillonnage de texture afin que la représentation compressée puisse rester résidente.
- Inférence sur retour
- Stratégie d'exécution qui utilise le retour de texture pour décoder et mettre en cache uniquement les tuiles demandées.
- Échange stockage-calcul de texture
- Un modèle Figure Rocks décrivant l'échange de stockage de texture, de bande passante et de VRAM contre un travail d'inférence neuronale supplémentaire sur le GPU.
- Test de valeur de texture neuronale
- Un flux de travail Figure Rocks pour décider si la compression de textures neuronale crée un bénéfice net pour un matériau particulier et un GPU cible.
Sources principales
NVIDIA Developer — RTX KitPrésentation officielle de la compression de textures neuronale RTX et du positionnement publié par NVIDIA en matière de réduction du stockage.
NVIDIA RTXNTC — SDK READMEDocumentation officielle du SDK décrivant la compression des canaux de matériaux, la représentation décodeur/latente, les modes d'exécution, des exemples de mémoire, les exigences système et la prise en charge de Cooperative Vector.
NVIDIA RTXNTC — VersionsHistorique officiel des versions, y compris la version bêta v0.10.0 et la prise en charge de l'inférence DirectX 12 Linear Algebra.
NVIDIA RTXNTC — Paramètres de compression et qualité d'imageDocumentation officielle couvrant le débit, les interactions entre canaux, la mesure de la qualité et le comportement de la compression avec perte.
NVIDIA — LibNTCDocumentation officielle de la bibliothèque d'exécution décrivant la configuration du décodeur et le compromis qualité/performance des différentes tailles de réseau de neurones.
Related Articles
Vous avez réduit les paramètres graphiques mais les FPS ne se sont pas améliorés ? Vous ne corrigez probablement pas le bon goulot d'étranglement
Vous réduisez les ombres, les effets et la résolution, mais les FPS changent à peine. Ce guide explique pourquoi les paramètres graphiques n'aident que lorsqu'ils réduisent la charge qui limite réellement la frame—et comment identifier les goulots d'étranglement liés au CPU, au GPU, à la mémoire, au streaming et au plafonnement des frames.
DirectStorage 1.4 ne fait pas décompresser vos jeux par votre SSD : ce que font réellement Zstd et la décompression GPU
DirectStorage 1.4 ajoute la compression Zstandard, la décompression GPU et une nouvelle Game Asset Conditioning Library, mais le SSD lui-même ne reste qu'une partie du pipeline de chargement. Ce guide explique ce que le SSD, DirectStorage, le CPU, le GPU et le moteur de jeu font réellement chacun.
FAQ amiibo : Les 20 questions que tout le monde se pose (et les réponses claires)
Une FAQ Amiibo sans fioritures : compatibilité, scan, régions, rééditions, valeur et règles de collection — des réponses claires pour que les débutants arrêtent de gaspiller de l'argent.
L'utilisation de la VRAM n'est pas une exigence de VRAM : pourquoi un indicateur de mémoire plein ne raconte pas toute l'histoire
Voir 7,8 Go utilisés sur une carte graphique de 8 Go peut sembler prouver qu'un jeu a épuisé sa VRAM. Ce n'est pas si simple. Ce guide explique la capacité de la VRAM, les budgets de résidence, les ensembles de travail, la mémoire partagée et comment déterminer si la pression mémoire est réellement à l'origine des saccades.
Windows Auto SR n'est pas le DLSS : comment fonctionne la mise à l'échelle par NPU sans intégration au jeu
Windows Auto SR peut mettre à l'échelle les jeux pris en charge sans intégration de DLSS, FSR ou XeSS. Au lieu d'exécuter le modèle de reconstruction dans le jeu sur le GPU, Windows utilise le NPU pour reconstruire une image en plus haute résolution à partir d'un rendu en plus basse résolution.
Corrections des saccades de streaming de stockage : quand les ressources ne suivent plus
Les saccades de streaming surviennent lors du chargement de nouvelles zones : limites de stockage, de décompression ou de streaming d'assets. Utilisez cet ordre de résolution avant de baisser tous les paramètres graphiques.
Stockage et streaming : réduire les temps de chargement sans créer de saccades
Un stockage rapide n'est utile que si le comportement de streaming est stable. Ce guide explique comment les E/S affectent les saccades et ce qu'il faut changer en premier.
DLSS 5 n'est pas qu'une simple mise à l'échelle : ce que le rendu neuronal guidé en 3D change réellement
DLSS 5 déplace l’IA vers une nouvelle partie du pipeline graphique. Au lieu de simplement reconstruire la résolution ou de générer des images supplémentaires, le rendu neuronal guidé en 3D utilise la propre image du moteur de jeu comme base et améliore l’éclairage et le détail des matériaux sous le contrôle du développeur.