
La compressione neurale delle texture RTX non è upscaling: come l'IA può scambiare memoria delle texture con potenza di calcolo della GPU
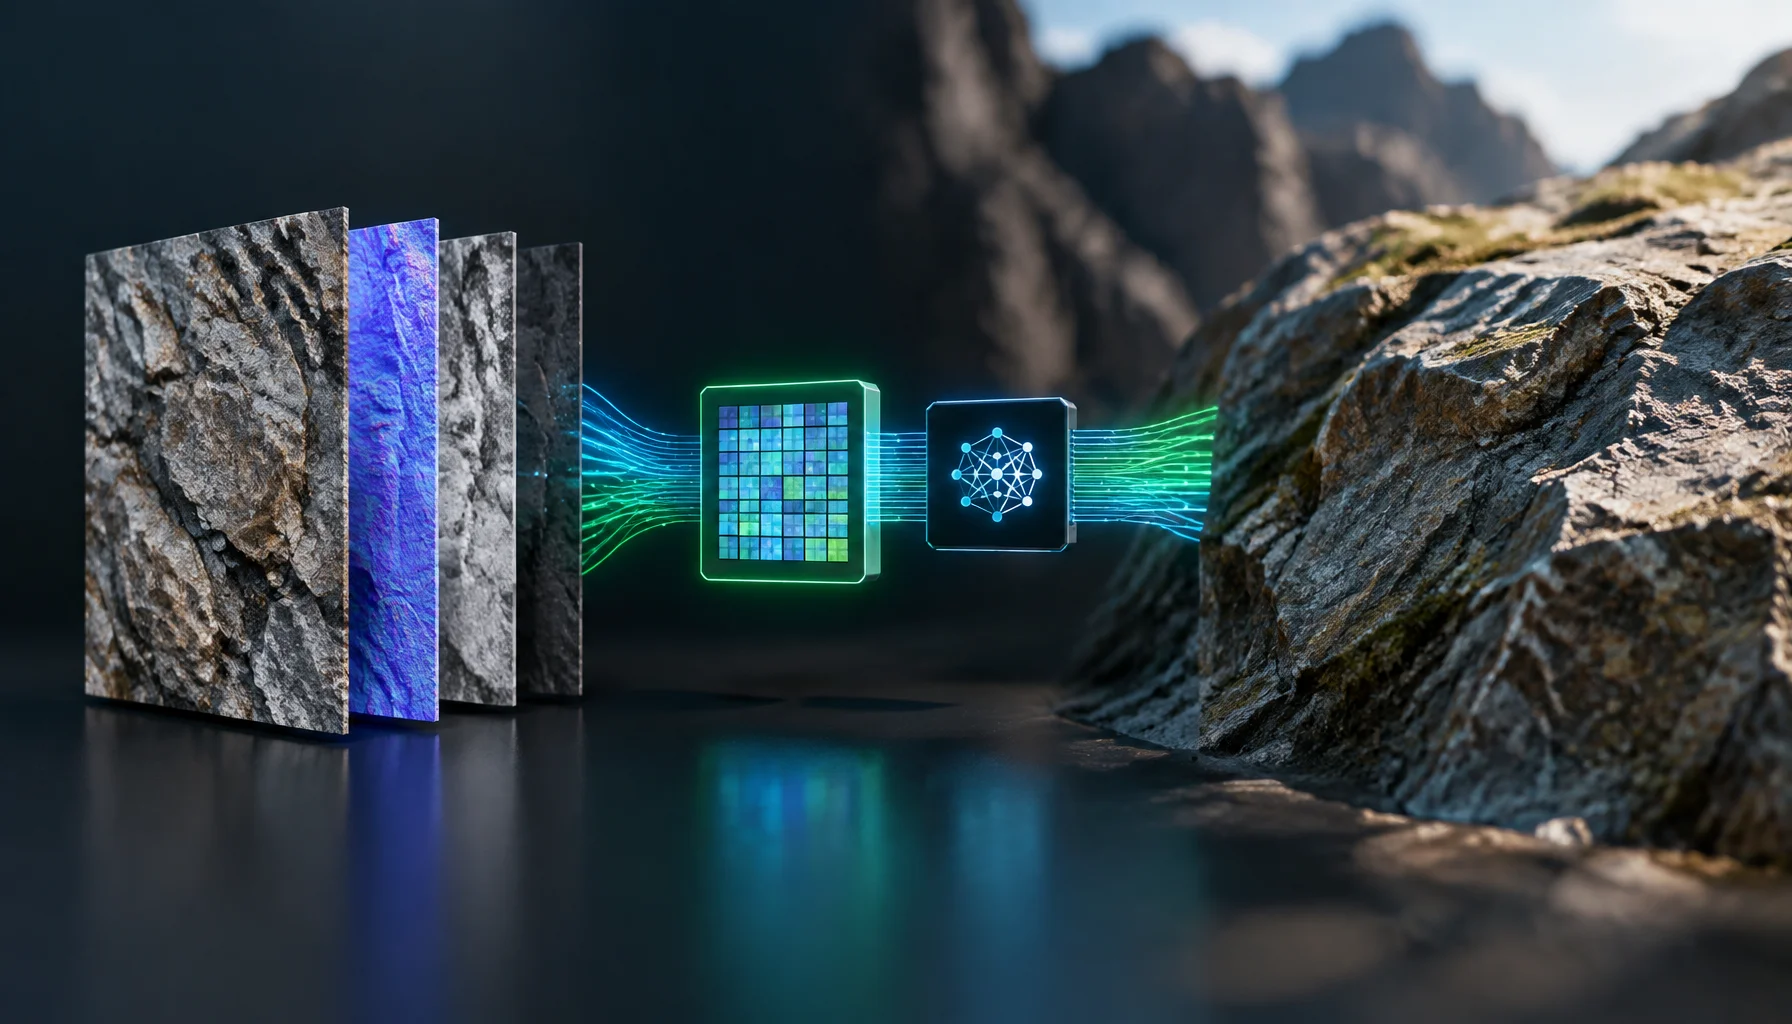
La compressione delle texture normalmente significa memorizzare una versione più piccola dei dati della texture ed espanderla in un formato GPU convenzionale prima o durante l'uso. NVIDIA RTX Neural Texture Compression cambia questo modello: parte dei dati della texture diventa una piccola rappresentazione neurale che può essere decodificata dalla GPU stessa.
Perché la normale compressione delle texture usa ancora molta memoria
Un moderno materiale basato sulla fisica raramente consiste in una sola immagine. Una singola superficie può utilizzare albedo, normal, roughness, metalness, occlusione ambientale, opacità e altri canali.
I formati tradizionali di compressione a blocchi GPU come BC1 fino a BC7 riducono il costo, ma la GPU finisce comunque per memorizzare blocchi di texture convenzionali per il materiale.
Man mano che la risoluzione delle texture e la complessità dei materiali aumentano, quei canali consumano spazio su disco, larghezza di banda in streaming e memoria GPU.
Cosa memorizza effettivamente RTX Neural Texture Compression
L'SDK RTXNTC di NVIDIA comprime insieme i canali appartenenti a un materiale. L'SDK attuale supporta fino a 16 canali di texture in un set di texture NTC.
Invece di mantenere solo texel compressi convenzionali, il processo di compressione produce due cose principali: pesi per un piccolo decoder neurale e dati di feature latenti compatti.
La pipeline delle texture neurali
Perché comprimere i canali insieme può aiutare
I canali del materiale sono spesso correlati. Un graffio visibile nel colore di base può apparire anche nella mappa normal o roughness. Un motivo di tessuto può influenzare diversi canali nella stessa posizione spaziale.
NVIDIA ha progettato NTC per sfruttare queste correlazioni invece di comprimere ogni texture in modo indipendente.
Questo è uno dei motivi per cui la tecnologia è descritta come compressione orientata al materiale piuttosto che semplicemente un altro formato immagine.
Le tre modalità runtime NTC sono la chiave per comprendere la tecnologia
La parte più importante di RTXNTC non è solo come viene compresso il materiale. È quando il gioco sceglie di decomprimerlo.
Inferenza al caricamento vs Inferenza al campionamento vs Inferenza al feedback
| Quando avviene la decodifica neurale | Comportamento della memoria texture a runtime | Compromesso principale | |
|---|---|---|---|
| Inferenza al caricamento | |||
| Inferenza al campionamento | |||
| Inferenza al feedback |
Inferenza al caricamento: compressione neurale come formato di archiviazione
L'Inferenza al caricamento è la modalità più semplice da comprendere.
Il gioco memorizza il materiale in forma NTC compatta. Quando l'asset viene caricato, la GPU ricostruisce i dati della texture e può transcodificarli nei formati di texture BCn ordinari.
Dopo questo passaggio, il rendering può utilizzare il campionamento texture normale. Il risparmio importante avviene principalmente prima della decompressione: dimensione del gioco pacchettizzato, dimensione del download o larghezza di banda dello streaming degli asset.
Ma una volta che il materiale è completamente espanso in texture convenzionali, il suo ingombro in VRAM a runtime si avvicina di nuovo alla rappresentazione convenzionale.
Inferenza al campionamento: mantenere la texture neurale in VRAM
L'Inferenza al campionamento è la modalità più radicale.
Invece di espandere il materiale in texture convenzionali prima del rendering, lo shader legge dati latenti compatti ed esegue il decodificatore neurale quando ha bisogno dei valori della texture.
L'esempio dell'SDK di NVIDIA confronta una rappresentazione del materiale BCn da 12 MB con una rappresentazione NTC da 2,5 MB quando si utilizza l'Inferenza al campionamento.
Il risparmio è reale perché i dati della texture convenzionale non devono rimanere completamente residenti. Ma il costo si sposta altrove: il pixel shader o l'hit shader ora esegue l'inferenza neurale.
Inferenza al feedback: decodificare solo ciò che il giocatore vede effettivamente
L'Inferenza al feedback si colloca tra i due estremi.
Il renderer tiene traccia di quali tile di texture sono effettivamente richiesti. Invece di espandere immediatamente l'intero materiale, il sistema può decodificare i tile richiesti in batch e mantenere una cache di lavoro.
Concettualmente, questo combina la compressione neurale con lo streaming delle texture: il sistema paga il costo di decodifica solo per le regioni che diventano rilevanti.
L'attuale implementazione di esempio è più specializzata rispetto alle altre modalità e i suoi vincoli di supporto differiscono, quindi dovrebbe essere trattata come una strategia di integrazione piuttosto che come un sostituto universale dello streaming di texture ordinario.
Lo scambio tra archiviazione delle texture e calcolo
Il modo più semplice per comprendere la compressione neurale delle texture è considerarla uno scambio tra risorse.
Cosa cambia quando l'archiviazione delle texture diventa neurale
| Texture compressa tradizionale | Rappresentazione neurale della texture | |
|---|---|---|
| Disco/archiviazione | ||
| VRAM | ||
| Costo di campionamento | ||
| Controllo qualità |
Perché l'hardware specializzato per matrici è importante
Eseguire una rete neurale per il campionamento delle texture sarebbe troppo costoso se ogni moltiplicazione dovesse essere gestita come un normale lavoro scalare dello shader.
RTXNTC trae quindi vantaggio da Cooperative Vector e ora dai percorsi DirectX 12 Linear Algebra che consentono agli shader di utilizzare l'hardware di accelerazione matriciale della GPU.
La beta v0.10.0 ha aggiunto esplicitamente l'inferenza tramite l'API DirectX 12 Linear Algebra introdotta con Shader Model 6.10.
Perché la compressione neurale delle texture non è upscaling delle texture
Entrambe le tecniche possono utilizzare il machine learning, ma risolvono problemi diversi.
Compressione neurale delle texture vs Super Resolution
| Compressione neurale delle texture | Super Resolution | |
|---|---|---|
| Input | ||
| Obiettivo | ||
| Quando viene eseguita | ||
| Output |
La compressione neurale delle texture può quindi esistere al di sotto di DLSS, FSR, XeSS o rendering nativo. Cambia il modo in cui i dati dei materiali vengono archiviati e ricostruiti, non la risoluzione finale di visualizzazione.
Il parametro di qualità è i bit per pixel
NTC è una compressione con perdita. La quantità di informazioni compresse è controllata in gran parte tramite l'impostazione dei bit per pixel.
Un bitrate più elevato fornisce al modello più informazioni e generalmente migliora la qualità della ricostruzione. Un bitrate più basso migliora la compressione ma aumenta il rischio di errori visibili.
Poiché più canali condividono la stessa rappresentazione, aggiungere più canali del materiale senza aumentare il bitrate può ridurre la qualità disponibile per ciascun canale.
Perché i canali del materiale correlati sono importanti
Una rappresentazione neurale diventa più preziosa quando diversi canali di materiale descrivono una struttura correlata.
Se albedo, normal e roughness contengono tutti gli stessi graffi, cuciture o trama del tessuto, il decoder può sfruttare le informazioni spaziali condivise.
Se i canali sono rumore non correlato, c'è meno struttura comune da sfruttare e il problema di compressione diventa più difficile.
Il test del valore della texture neurale
Quando la compressione neurale delle texture è realmente utile?
Perché “8× più piccolo” necessita di contesto
RTX Kit di NVIDIA descrive RTX Neural Texture Compression come in grado di offrire fino a 8× di miglioramento della memoria su disco a una fedeltà visiva simile alla compressione a blocchi tradizionale.
La frase “fino a” è importante. Il rapporto di compressione dipende dal materiale, dal numero di canali, dal bitrate target, dalla configurazione del decoder e dalla soglia di qualità.
Lo stesso rapporto non descrive automaticamente il risparmio di VRAM. L'inferenza al caricamento può partire da un file compatto e comunque espandersi in texture GPU convenzionali. L'inferenza al campionamento preserva la rappresentazione compatta nella memoria GPU ma spende più calcolo durante lo shading.
La dimensione del decoder è un altro compromesso prestazioni-qualità
Il runtime NTC utilizza un piccolo percettrone multistrato per decodificare i valori delle texture.
L'attuale libreria di NVIDIA utilizza un'architettura decoder configurabile. Reti più grandi possono migliorare la qualità di compressione ma costano di più da eseguire; reti più piccole possono funzionare più velocemente con qualche perdita di qualità di ricostruzione.
Ciò offre agli sviluppatori di engine un'altra dimensione di tuning oltre alla risoluzione delle texture e al bitrate.
Perché questo è importante per le future installazioni di giochi
I giochi moderni distribuiscono sempre più set di materiali ad alta risoluzione che influenzano sia la dimensione del download che la memoria a runtime.
La compressione neurale delle texture crea una nuova opzione: distribuire una rappresentazione compatta appresa e decidere in seguito se espanderla al caricamento, ricostruirla direttamente durante lo shading o decodificare solo le tile richieste.
Ciò significa che una singola rappresentazione compressa di asset può partecipare a diverse strategie di memoria a runtime.
Cambia anche cosa significa 'memoria delle texture'
Con il rendering tradizionale, un budget di memoria delle texture riguarda principalmente formati delle texture, livelli mip, risoluzione e residenza.
Con le texture neurali, gli sviluppatori possono anche preventivare dati latenti, pesi del decoder, buffer di inferenza, cache transcodificate e la potenza di calcolo necessaria per ricostruire i valori richiesti.
Quindi l'asset non ha più una sola semplice identità di memoria fissa.
Il supporto cross-vendor è più sfumato di quanto suggerisca il nome RTX
RTXNTC è un SDK NVIDIA, e la compressione stessa attualmente richiede una GPU NVIDIA secondo i requisiti dell'SDK.
La decompressione a runtime è più ampia. NVIDIA documenta percorsi funzionali su hardware Shader Model 6 e segnala la validazione su GPU NVIDIA, AMD e Intel, mentre i percorsi avanzati Cooperative Vector / Linear Algebra dipendono dal supporto API e driver.
Prestazioni e parità di funzionalità non dovrebbero quindi essere date per scontate tra i vari vendor solo perché il decoder di base può essere eseguito.
Cosa cambierebbe questa risposta?
NTC è ancora in beta. Modalità di runtime, architetture dei decoder, supporto dei driver e percorsi di integrazione possono cambiare prima di una release stabile per la produzione.
Il cambiamento più grande a lungo termine sarebbe l'adozione diffusa di primitive standardizzate per shader neurali in DirectX e Vulkan. Ciò renderebbe la decodifica delle texture neurali meno dipendente da percorsi di esecuzione personalizzati specifici del vendor.
Limitazioni
Questo articolo descrive l'architettura e il comportamento attuale dell'SDK RTXNTC pubblico. Le dichiarazioni di compressione citate da NVIDIA sono fornite dal vendor e non dovrebbero essere considerate risultati garantiti per ogni materiale.
L'SDK attuale è software in beta, e alcuni percorsi di anteprima hanno limitazioni documentate di driver e piattaforma.
Conclusione
RTX Neural Texture Compression è interessante perché cambia un presupposto molto vecchio: il dettaglio delle texture non deve sempre esistere in memoria come texel convenzionali.
Un materiale può invece essere memorizzato in parte come una rappresentazione appresa compatta e ricostruito quando necessario.
Ciò non offre qualità gratuita o memoria gratuita. Crea un nuovo scambio: meno archiviazione, larghezza di banda e potenzialmente VRAM in cambio di lavoro di inferenza neurale.
La vera innovazione non è "l'IA rende le texture più nitide". È che parte dei dati dei materiali di un gioco può diventare calcolo.
FAQ
RTX Neural Texture Compression spiegato in parole semplici
RTX Neural Texture Compression è un upscaler?
NTC può ridurre l'utilizzo della VRAM?
Cosa memorizza la rete neurale?
NTC decodifica l'intera texture prima del rendering?
La compressione neurale delle texture è senza perdita?
RTXNTC è pronto per la produzione?
Glossario
Termini chiave delle texture neurali
- Neural Texture Compression
- Una tecnica che memorizza le informazioni delle texture come dati latenti compatti più i pesi del decoder neurale invece che solo come blocchi di texel convenzionali.
- Dati latenti
- Feature compatte apprese che il decoder neurale utilizza per ricostruire i valori delle texture.
- Decoder
- Una piccola rete neurale che converte le feature latenti in canali di texture ricostruiti.
- Inference on Load
- Modalità di runtime che decodifica la texture neurale quando un asset viene caricato, solitamente in formati di texture convenzionali.
- Inference on Sample
- Modalità di runtime che esegue la decodifica neurale direttamente durante il campionamento della texture, così la rappresentazione compressa può rimanere residente.
- Inference on Feedback
- Strategia di runtime che utilizza il feedback delle texture per decodificare e memorizzare nella cache solo i tile richiesti.
- Texture Storage–Compute Exchange
- Un modello di Figure Rocks che descrive lo scambio di archiviazione delle texture, larghezza di banda e VRAM per ulteriore lavoro di inferenza neurale sulla GPU.
- Neural Texture Value Test
- Un flusso di lavoro di Figure Rocks per decidere se la compressione neurale delle texture crea un beneficio netto per un particolare materiale e una GPU target.
Fonti primarie
NVIDIA Developer — RTX KitPanoramica ufficiale di RTX Neural Texture Compression e del posizionamento pubblicato da NVIDIA sulla riduzione dell'archiviazione.
NVIDIA RTXNTC — SDK READMEDocumentazione ufficiale dell'SDK che descrive la compressione dei canali dei materiali, la rappresentazione decoder/latente, le modalità di runtime, esempi di memoria, requisiti di sistema e supporto Cooperative Vector.
NVIDIA RTXNTC — ReleasesCronologia ufficiale delle release, inclusa la beta v0.10.0 e il supporto all'inferenza DirectX 12 Linear Algebra.
NVIDIA RTXNTC — Compression Settings and Image QualityDocumentazione ufficiale che copre bitrate, interazioni tra canali, misurazione della qualità e comportamento della compressione con perdita.
NVIDIA — LibNTCDocumentazione ufficiale della libreria di runtime che descrive la configurazione del decoder e il compromesso qualità/prestazioni delle diverse dimensioni della rete neurale.
Related Articles
Hai abbassato le impostazioni grafiche ma gli FPS non sono migliorati? Probabilmente stai ottimizzando il collo di bottiglia sbagliato
Riduci ombre, effetti e risoluzione, ma gli FPS cambiano a malapena. Questa guida spiega perché le impostazioni grafiche aiutano solo quando riducono il carico che sta effettivamente limitando il frame—e come identificare i colli di bottiglia di CPU, GPU, memoria, streaming e limite di frame.
Archiviazione e streaming: ridurre i tempi di caricamento senza creare stuttering
Lo storage veloce aiuta solo quando il comportamento dello streaming è stabile. Questa guida spiega come l'IO influisce sullo stutter e cosa cambiare per primo.
Soluzioni per lo stuttering dello streaming dall'archiviazione: quando gli asset non tengono il passo
Lo stuttering da streaming si verifica quando vengono caricate nuove aree: limiti di archiviazione, decompressione o streaming degli asset. Usa questo ordine di correzione prima di abbassare ogni impostazione grafica.
L'utilizzo della VRAM non è il requisito di VRAM: perché un misuratore di memoria pieno non racconta tutta la storia
Vedere 7,8 GB utilizzati su una scheda grafica da 8 GB può sembrare la prova che un gioco ha esaurito la VRAM. Non è così semplice. Questa guida spiega la capacità della VRAM, i budget di residenza, i working set, la memoria condivisa e come capire se la pressione sulla memoria sta effettivamente causando stutter.
DirectStorage 1.4 non fa decomprimere i giochi al tuo SSD: cosa fanno realmente Zstd e la decompressione GPU
DirectStorage 1.4 aggiunge la compressione Zstandard, la decompressione GPU e una nuova Game Asset Conditioning Library, ma l'SSD stesso è ancora solo una parte della pipeline di caricamento. Questa guida spiega cosa fanno effettivamente l'SSD, DirectStorage, la CPU, la GPU e il motore di gioco.
Windows Auto SR non è DLSS: come funziona l'upscaling NPU senza integrazione nel gioco
Windows Auto SR può eseguire l'upscaling dei giochi supportati senza l'integrazione di DLSS, FSR o XeSS. Invece di eseguire il modello di ricostruzione all'interno del gioco sulla GPU, Windows utilizza la NPU per ricostruire un'immagine a risoluzione più elevata a partire da un rendering a risoluzione inferiore.
amiibo FAQ: Le 20 domande che si fanno tutti (e le risposte dirette)
Una FAQ sugli Amiibo senza fronzoli: compatibilità, scansione, regioni, ristampe, valore e regole di collezionismo — risposte chiare affinché i principianti smettano di sprecare soldi.
DLSS 5 non è solo upscaling: cosa cambia realmente il rendering neurale guidato in 3D
DLSS 5 sposta l'IA in una nuova parte della pipeline grafica. Invece di ricostruire solo la risoluzione o generare frame aggiuntivi, il 3D-Guided Neural Rendering utilizza il frame del motore di gioco stesso come base e migliora l'illuminazione e il dettaglio dei materiali sotto il controllo dello sviluppatore.