
Сжатие текстур с помощью нейросетей RTX — это не апскейлинг: как ИИ позволяет обменивать память для текстур на вычислительные ресурсы GPU
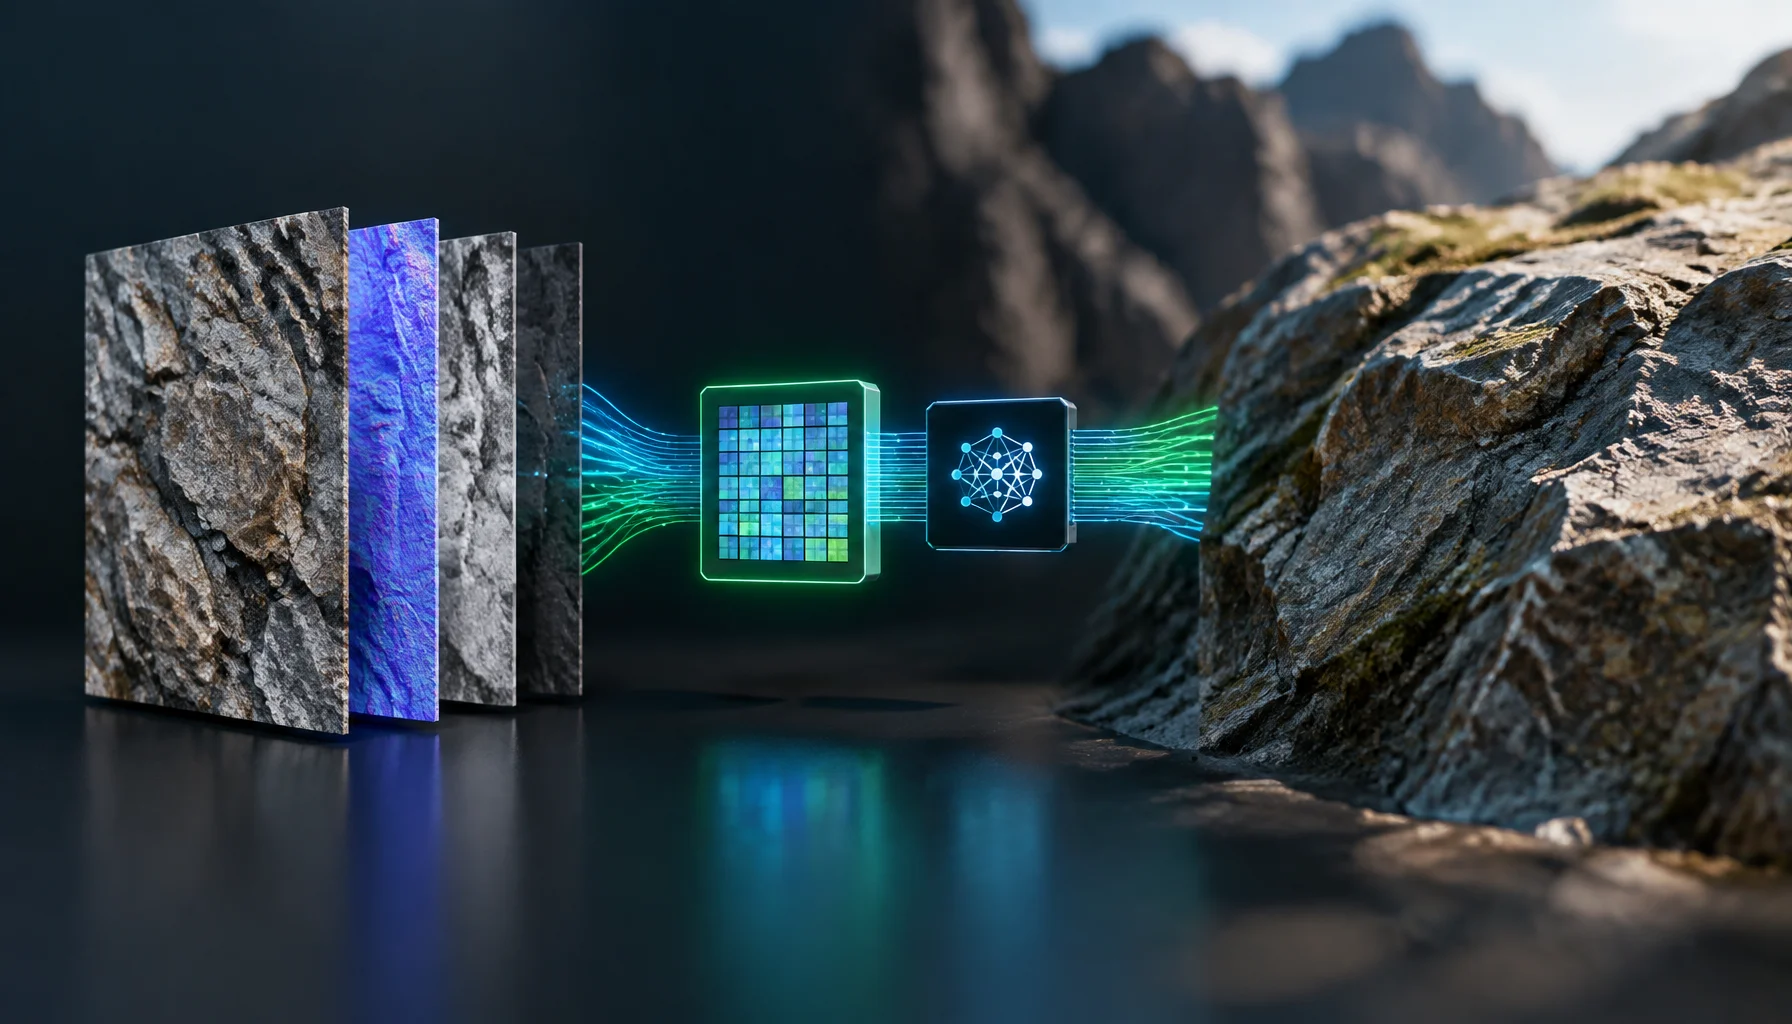
Обычно под сжатием текстур понимают хранение уменьшенной версии текстурных данных и её развёртывание в обычный формат GPU до или во время использования. NVIDIA RTX Neural Texture Compression меняет эту модель: часть текстурных данных становится небольшим нейросетевым представлением, которое может декодироваться самим GPU.
Почему обычное сжатие текстур всё ещё требует много памяти
Современный физически корректный материал редко состоит из одного изображения. Одна поверхность может использовать альбедо, нормали, шероховатость, металличность, ambient occlusion, прозрачность и другие каналы.
Традиционные форматы блочного сжатия GPU, такие как BC1–BC7, снижают затраты, но GPU всё равно хранит обычные текстурные блоки для материала.
По мере увеличения разрешения текстур и сложности материалов эти каналы потребляют дисковое пространство, пропускную способность потоковой передачи и память GPU.
Что на самом деле хранит RTX Neural Texture Compression
SDK RTXNTC от NVIDIA сжимает каналы, принадлежащие одному материалу, вместе. Текущий SDK поддерживает до 16 текстурных каналов в одном наборе текстур NTC.
Вместо хранения только обычных сжатых текселей процесс сжатия создаёт две основные вещи: веса для небольшого нейронного декодера и компактные латентные признаки.
Конвейер нейронных текстур
Почему совместное сжатие каналов может помочь
Каналы материала часто связаны. Царапина, видимая в базовом цвете, может также появляться в карте нормалей или шероховатости. Узор ткани может влиять на несколько каналов в одном и том же пространственном месте.
NVIDIA разработала NTC, чтобы использовать эти корреляции вместо независимого сжатия каждой текстуры.
Это одна из причин, по которой технологию описывают как сжатие, ориентированное на материал, а не просто как ещё один формат изображения.
Три режима выполнения NTC — ключ к пониманию технологии
Самая важная часть RTXNTC — не только то, как сжимается материал. Важно то, когда игра решает его распаковать.
Вывод при загрузке vs Вывод при сэмплировании vs Вывод по обратной связи
| Когда происходит нейронное декодирование | Поведение текстурной памяти во время выполнения | Основной компромисс | |
|---|---|---|---|
| Вывод при загрузке | |||
| Вывод при сэмплировании | |||
| Вывод по обратной связи |
Вывод при загрузке: нейронное сжатие как формат хранения
Вывод при загрузке — самый простой для понимания режим.
Игра хранит материал в компактной форме NTC. Когда ресурс загружается, GPU восстанавливает данные текстуры и может перекодировать их в обычные форматы текстур BCn.
После этого шага рендеринг может использовать обычную выборку текстур. Основная экономия происходит главным образом до декомпрессии: размер упакованной игры, размер загрузки или пропускная способность потоковой передачи ресурсов.
Но как только материал полностью разворачивается в обычные текстуры, его потребление VRAM во время выполнения снова приближается к обычному представлению.
Вывод при сэмплировании: сохранение текстуры нейронной в VRAM
Вывод при сэмплировании — более радикальный режим.
Вместо разворачивания материала в обычные текстуры перед рендерингом шейдер читает компактные латентные данные и запускает нейронный декодер, когда ему нужны значения текстуры.
Пример из собственного SDK NVIDIA сравнивает представление материала BCn размером 12 МБ с представлением NTC размером 2,5 МБ при использовании вывода при сэмплировании.
Экономия реальна, потому что обычные данные текстуры не должны оставаться полностью резидентными. Но затраты перемещаются в другое место: пиксельный шейдер или шейдер попаданий теперь выполняет нейронный вывод.
Вывод по обратной связи: декодировать только то, что игрок действительно видит
Вывод по обратной связи находится между двумя крайностями.
Рендерер отслеживает, какие тайлы текстуры фактически запрашиваются. Вместо немедленного разворачивания всего материала система может декодировать запрошенные тайлы пакетами и поддерживать рабочий кэш.
Концептуально это сочетает нейронное сжатие с потоковой передачей текстур: система платит за декодирование только для тех областей, которые становятся релевантными.
Текущая реализация примера более специализирована, чем другие режимы, и её ограничения по поддержке отличаются, поэтому её следует рассматривать как стратегию интеграции, а не как универсальную замену обычной потоковой передачи текстур.
Обмен между хранением текстур и вычислениями
Самый простой способ понять нейронное сжатие текстур — рассматривать его как обмен между ресурсами.
Что меняется, когда хранение текстур становится нейронным
| Традиционная сжатая текстура | Нейронное представление текстуры | |
|---|---|---|
| Диск/хранилище | ||
| VRAM | ||
| Стоимость выборки | ||
| Контроль качества |
Почему важны специализированные матричные аппаратные средства
Запуск нейронной сети для выборки текстур был бы слишком дорогим, если бы каждое умножение приходилось обрабатывать как обычную скалярную работу шейдера.
Поэтому RTXNTC выигрывает от Cooperative Vector и теперь путей DirectX 12 Linear Algebra, которые позволяют шейдерам использовать аппаратное ускорение матричных операций на GPU.
Бета-версия v0.10.0 явно добавила вывод через API DirectX 12 Linear Algebra, представленный с Shader Model 6.10.
Почему нейронное сжатие текстур — это не апскейлинг текстур
Обе техники могут использовать машинное обучение, но они решают разные задачи.
Нейронное сжатие текстур против суперразрешения
| Нейронное сжатие текстур | Суперразрешение | |
|---|---|---|
| Вход | ||
| Цель | ||
| Когда выполняется | ||
| Выход |
Таким образом, нейронное сжатие текстур может существовать под DLSS, FSR, XeSS или нативным рендерингом. Оно меняет способ хранения и восстановления данных материалов, а не итоговое разрешение дисплея.
Ручка качества — это биты на пиксель
NTC — это сжатие с потерями. Объём сжатой информации в основном контролируется настройкой битов на пиксель.
Более высокий битрейт даёт модели больше информации и обычно улучшает качество восстановления. Более низкий битрейт улучшает сжатие, но увеличивает риск видимых ошибок.
Поскольку несколько каналов используют одно и то же представление, добавление новых каналов материала без увеличения битрейта может снизить качество, доступное каждому каналу.
Почему важны коррелированные каналы материалов
Нейронное представление становится более ценным, когда несколько материальных каналов описывают связанную структуру.
Если альбедо, нормали и шероховатость содержат одинаковые царапины, швы или переплетение ткани, декодер может использовать общую пространственную информацию.
Если каналы представляют собой несвязанный шум, общей структуры для использования меньше, и задача сжатия становится сложнее.
Тест ценности нейронных текстур
Когда нейронное сжатие текстур действительно полезно?
Почему «в 8 раз меньше» требует контекста
NVIDIA RTX Kit описывает RTX Neural Texture Compression как обеспечивающее до 8-кратного улучшения дискового пространства при визуальной точности, близкой к традиционному блочному сжатию.
Фраза «до» имеет значение. Степень сжатия зависит от материала, количества каналов, целевого битрейта, конфигурации декодера и порога качества.
Тот же коэффициент также не описывает автоматически экономию видеопамяти. Вывод при загрузке может начинаться с компактного файла и всё равно разворачиваться в обычные GPU-текстуры. Вывод при выборке сохраняет компактное представление в памяти GPU, но расходует больше вычислений во время шейдинга.
Размер декодера — ещё один компромисс между производительностью и качеством
Среда выполнения NTC использует небольшой многослойный перцептрон для декодирования значений текстуры.
Текущая библиотека NVIDIA использует настраиваемую архитектуру декодера. Более крупные сети могут улучшить качество сжатия, но требуют больше затрат на выполнение; меньшие сети могут работать быстрее с некоторой потерей качества реконструкции.
Это даёт разработчикам движков ещё одно измерение для настройки помимо разрешения текстур и битрейта.
Почему это важно для будущих установок игр
Современные игры всё чаще поставляются с наборами материалов высокого разрешения, которые влияют как на размер загрузки, так и на память во время выполнения.
Нейронное сжатие текстур создаёт новую возможность: поставлять компактное обученное представление и позже решать, разворачивать ли его при загрузке, реконструировать ли напрямую во время шейдинга или декодировать только запрошенные тайлы.
Это означает, что одно сжатое представление ресурса может участвовать в нескольких различных стратегиях использования памяти во время выполнения.
Это также меняет значение термина «память текстур»
При традиционном рендеринге бюджет памяти под текстуры в основном определяется форматами текстур, уровнями mip, разрешением и резидентностью.
С нейронными текстурами разработчикам также приходится учитывать латентные данные, веса декодера, буферы вывода, кэши транскодирования и вычисления, необходимые для восстановления запрошенных значений.
Таким образом, у актива больше нет одной простой фиксированной идентичности в памяти.
Кроссплатформенная поддержка сложнее, чем предполагает название RTX
RTXNTC — это SDK от NVIDIA, и само сжатие в настоящее время требует GPU NVIDIA в соответствии с требованиями SDK.
Декомпрессия во время выполнения шире. NVIDIA документирует функциональные пути на оборудовании Shader Model 6 и отмечает валидацию на GPU NVIDIA, AMD и Intel, тогда как продвинутые пути Cooperative Vector / Linear Algebra зависят от поддержки API и драйвера.
Поэтому не следует предполагать равенство производительности и функциональности между производителями только потому, что базовый декодер может работать.
Что могло бы изменить этот ответ?
NTC всё ещё находится в стадии бета-тестирования. Режимы выполнения, архитектуры декодеров, поддержка драйверов и пути интеграции могут измениться до стабильного производственного релиза.
Самым большим долгосрочным изменением стало бы широкое внедрение стандартизированных нейронных шейдерных примитивов в DirectX и Vulkan. Это сделало бы декодирование нейронных текстур менее зависимым от пользовательских путей выполнения, специфичных для конкретного производителя.
Ограничения
В этой статье описывается архитектура и текущее публичное поведение RTXNTC SDK. Приведённые NVIDIA заявления о сжатии предоставлены производителем и не должны рассматриваться как гарантированные результаты для каждого материала.
Текущий SDK является бета-версией программного обеспечения, и некоторые предварительные пути имеют документированные ограничения драйверов и платформ.
Заключение
RTX Neural Texture Compression интересна тем, что меняет очень старое предположение: детализация текстур не всегда должна существовать в памяти в виде обычных текселей.
Вместо этого материал может храниться частично в виде компактного обученного представления и восстанавливаться при необходимости.
Это не даёт бесплатного качества или бесплатной памяти. Это создаёт новый обмен: меньше хранения, пропускной способности и потенциально VRAM в обмен на работу нейронного вывода.
Настоящая инновация не в том, что «ИИ делает текстуры чётче». А в том, что часть данных материалов игры может стать вычислением.
Часто задаваемые вопросы
RTX Neural Texture Compression простыми словами
Является ли RTX Neural Texture Compression апскейлером?
Может ли NTC снизить потребление видеопамяти?
Что хранит нейронная сеть?
Декодирует ли NTC всю текстуру перед рендерингом?
Является ли нейронное сжатие текстур сжатием без потерь?
Готов ли RTXNTC к использованию в продакшене?
Глоссарий
Ключевые термины нейронных текстур
- Neural Texture Compression
- Техника, которая хранит информацию о текстуре в виде компактных латентных данных плюс весов нейронного декодера вместо только обычных блоков текселей.
- Латентные данные
- Компактные обученные признаки, которые нейронный декодер использует для восстановления значений текстуры.
- Декодер
- Небольшая нейронная сеть, которая преобразует латентные признаки в восстановленные каналы текстуры.
- Inference on Load
- Режим времени выполнения, который декодирует нейронную текстуру при загрузке ассета, обычно в обычные форматы текстур.
- Inference on Sample
- Режим времени выполнения, который выполняет нейронное декодирование непосредственно во время выборки текстуры, чтобы сжатое представление могло оставаться в памяти.
- Inference on Feedback
- Стратегия времени выполнения, которая использует обратную связь по текстурам для декодирования и кэширования только запрошенных тайлов.
- Texture Storage–Compute Exchange
- Модель Figure Rocks, описывающая обмен хранилища текстур, пропускной способности и видеопамяти на дополнительную работу GPU по нейронному выводу.
- Neural Texture Value Test
- Рабочий процесс Figure Rocks для определения того, даёт ли нейронное сжатие текстур чистую выгоду для конкретного материала и целевого GPU.
Первоисточники
NVIDIA Developer — RTX KitОфициальный обзор RTX Neural Texture Compression и опубликованное NVIDIA позиционирование по сокращению объёма хранилища.
NVIDIA RTXNTC — SDK READMEОфициальная документация SDK, описывающая сжатие каналов материалов, представление декодера/латентных данных, режимы времени выполнения, примеры использования памяти, системные требования и поддержку Cooperative Vector.
NVIDIA RTXNTC — ReleasesОфициальная история релизов, включая бета-версию v0.10.0 и поддержку вывода DirectX 12 Linear Algebra.
NVIDIA RTXNTC — Compression Settings and Image QualityОфициальная документация, охватывающая битрейт, взаимодействие каналов, измерение качества и поведение сжатия с потерями.
NVIDIA — LibNTCОфициальная документация библиотеки времени выполнения, описывающая конфигурацию декодера и компромисс между качеством и производительностью для нейронных сетей разного размера.
Related Articles
DLSS 5 — это не просто апскейлинг: что на самом деле меняет нейронный рендеринг с 3D-направлением
DLSS 5 переносит ИИ в новую часть графического конвейера. Вместо того чтобы только восстанавливать разрешение или генерировать дополнительные кадры, 3D-Guided Neural Rendering использует собственный кадр игрового движка в качестве основы и улучшает детализацию освещения и материалов под контролем разработчика.
Хранилище и стриминг: сокращение времени загрузки без появления статтеров
Быстрое хранилище помогает только тогда, когда поведение стриминга стабильно. Это руководство объясняет, как IO влияет на статтеры и что нужно изменить в первую очередь.
amiibo FAQ: 20 вопросов, которые задают все (и прямые ответы)
FAQ по Amiibo без лишней воды: совместимость, сканирование, регионы, переиздания, ценность и правила коллекционирования — четкие ответы, чтобы новички перестали тратить деньги впустую.
Исправления для заиканий стриминга хранилища: Когда ассеты не поспевают
Статтеры при стриминге возникают при загрузке новых областей: из-за ограничений хранилища, декомпрессии или стриминга ассетов. Используйте этот порядок исправлений, прежде чем снижать все настройки графики.
DirectStorage 1.4 не заставляет ваш SSD распаковывать игры: что на самом деле делают Zstd и распаковка на GPU
DirectStorage 1.4 добавляет сжатие Zstandard, распаковку на GPU и новую библиотеку Game Asset Conditioning Library, но сам SSD по-прежнему остаётся лишь одной из частей конвейера загрузки. В этом руководстве объясняется, что именно делают SSD, DirectStorage, CPU, GPU и игровой движок.
Использование VRAM — это не требование к VRAM: почему заполненный индикатор памяти не рассказывает всей истории
Видя 7,8 ГБ использованной памяти на 8-гигабайтной видеокарте, можно подумать, что игра исчерпала видеопамять. Но всё не так просто. Это руководство объясняет объём видеопамяти, бюджеты резидентности, рабочие наборы, разделяемую память и то, как определить, действительно ли нехватка памяти вызывает подтормаживания.
Снизили настройки графики, но FPS не вырос? Вероятно, вы оптимизируете не то узкое место
Ты снижаешь тени, эффекты и разрешение, но FPS почти не меняется. Это руководство объясняет, почему графические настройки помогают только тогда, когда они снижают нагрузку, которая на самом деле ограничивает кадр, — и как определить узкие места процессора, видеокарты, памяти, потоковой подгрузки и ограничения частоты кадров.
Windows Auto SR — это не DLSS: как работает апскейлинг на NPU без интеграции в игры
Windows Auto SR может масштабировать поддерживаемые игры без интеграции DLSS, FSR или XeSS. Вместо запуска модели реконструкции внутри игры на GPU Windows использует NPU, чтобы воссоздать изображение с более высоким разрешением из рендера с более низким разрешением.