
RTX Neural Texture Compression ist kein Upscaling: Wie KI Texturspeicher gegen GPU-Rechenleistung eintauschen kann
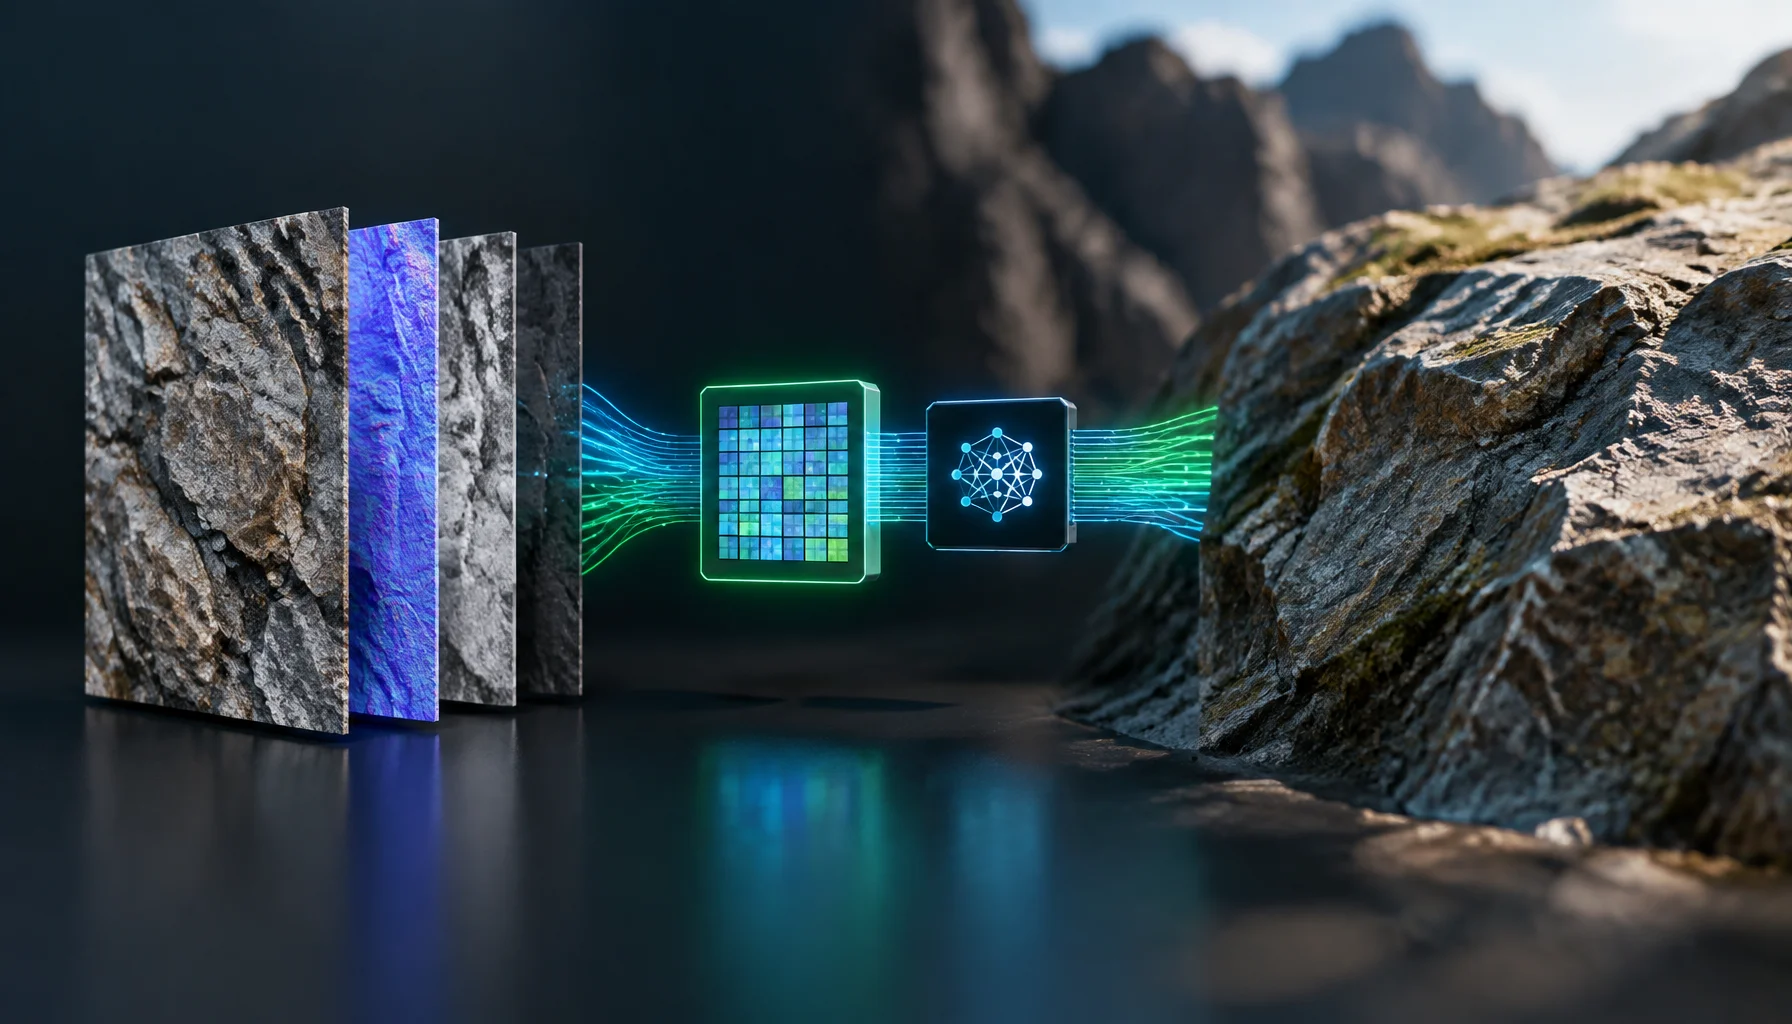
Texturkomprimierung bedeutet normalerweise, eine kleinere Version der Texturdaten zu speichern und sie vor oder während der Nutzung in ein konventionelles GPU-Format zu expandieren. NVIDIA RTX Neural Texture Compression ändert dieses Modell: Ein Teil der Texturdaten wird zu einer kleinen neuronalen Repräsentation, die von der GPU selbst dekodiert werden kann.
Warum normale Texturkomprimierung immer noch viel Speicher verbraucht
Ein modernes physikalisch basiertes Material besteht selten aus einem einzigen Bild. Eine einzelne Oberfläche kann Albedo, Normal, Rauheit, Metallizität, Umgebungsverdeckung, Opazität und andere Kanäle verwenden.
Traditionelle GPU-Blockkomprimierungsformate wie BC1 bis BC7 reduzieren die Kosten, aber die GPU speichert am Ende immer noch konventionelle Texturblöcke für das Material.
Mit zunehmender Texturauflösung und Materialkomplexität verbrauchen diese Kanäle Speicherplatz, Streaming-Bandbreite und GPU-Speicher.
Was RTX Neural Texture Compression tatsächlich speichert
NVIDIAs RTXNTC SDK komprimiert die zu einem Material gehörenden Kanäle gemeinsam. Das aktuelle SDK unterstützt bis zu 16 Texturkanäle in einem NTC-Texturset.
Anstatt nur konventionelle komprimierte Texel zu behalten, erzeugt der Komprimierungsprozess zwei Hauptdinge: Gewichte für einen kleinen neuronalen Decoder und kompakte latente Feature-Daten.
Die neuronale Textur-Pipeline
Warum das gemeinsame Komprimieren von Kanälen helfen kann
Materialkanäle sind oft miteinander verbunden. Ein in der Grundfarbe sichtbarer Kratzer kann auch in der Normal- oder Rauheitsmap erscheinen. Ein Stoffmuster kann mehrere Kanäle an derselben räumlichen Position beeinflussen.
NVIDIA hat NTC entwickelt, um diese Korrelationen auszunutzen, anstatt jede Textur unabhängig zu komprimieren.
Das ist einer der Gründe, warum die Technologie als materialorientierte Komprimierung beschrieben wird und nicht nur als ein weiteres Bildformat.
Die drei NTC-Laufzeitmodi sind der Schlüssel zum Verständnis der Technologie
Der wichtigste Teil von RTXNTC ist nicht nur, wie das Material komprimiert wird. Es ist, wann das Spiel sich entscheidet, es zu dekomprimieren.
Inferenz beim Laden vs. Inferenz beim Sampling vs. Inferenz beim Feedback
| Wann die neuronale Dekodierung stattfindet | Laufzeitverhalten des Texturspeichers | Hauptkompromiss | |
|---|---|---|---|
| Inferenz beim Laden | |||
| Inferenz beim Sampling | |||
| Inferenz beim Feedback |
Inferenz beim Laden: neuronale Kompression als Speicherformat
Inferenz beim Laden ist der am einfachsten zu verstehende Modus.
Das Spiel speichert das Material in kompakter NTC-Form. Wenn das Asset geladen wird, rekonstruiert die GPU die Texturdaten und kann sie in gewöhnliche BCn-Texturformate transkodieren.
Danach kann das Rendering normales Textursampling verwenden. Die wesentliche Einsparung liegt vor allem vor der Dekompression: Paketgröße des Spiels, Downloadgröße oder Bandbreite für Asset-Streaming.
Doch sobald das Material vollständig in konventionelle Texturen expandiert ist, nähert sich sein VRAM-Fußabdruck zur Laufzeit wieder der konventionellen Darstellung an.
Inferenz beim Sampling: Die Textur im VRAM neuronal halten
Inferenz beim Sampling ist der radikalere Modus.
Anstatt das Material vor dem Rendering in konventionelle Texturen zu expandieren, liest der Shader kompakte latente Daten und führt den neuronalen Decoder aus, wenn er Texturwerte benötigt.
NVIDIAs eigenes SDK-Beispiel vergleicht eine 12 MB große BCn-Materialdarstellung mit einer 2,5 MB großen NTC-Darstellung bei Verwendung von Inferenz beim Sampling.
Die Einsparung ist real, weil die konventionellen Texturdaten nicht vollständig resident bleiben müssen. Aber die Kosten verlagern sich woandershin: Der Pixel- oder Hit-Shader führt nun die neuronale Inferenz durch.
Inferenz beim Feedback: Nur dekodieren, was der Spieler tatsächlich sieht
Inferenz beim Feedback liegt zwischen den beiden Extremen.
Der Renderer verfolgt, welche Texturkacheln tatsächlich angefordert werden. Anstatt das vollständige Material sofort zu expandieren, kann das System angeforderte Kacheln in Stapeln dekodieren und einen Arbeitscache beibehalten.
Konzeptionell kombiniert dies neuronale Kompression mit Textur-Streaming: Das System zahlt die Dekodierungskosten nur für Regionen, die relevant werden.
Die aktuelle Beispielimplementierung ist spezialisierter als die anderen Modi und ihre Unterstützungsbedingungen unterscheiden sich, daher sollte sie als Integrationsstrategie und nicht als universeller Ersatz für gewöhnliches Textur-Streaming betrachtet werden.
Der Austausch zwischen Texturspeicher und Berechnung
Der einfachste Weg, neuronale Texturkompression zu verstehen, ist sie als einen Austausch zwischen Ressourcen zu betrachten.
Was sich verschiebt, wenn Texturspeicher neuronal wird
| Traditionelle komprimierte Textur | Neuronale Texturrepräsentation | |
|---|---|---|
| Datenträger/Speicher | ||
| VRAM | ||
| Sampling-Kosten | ||
| Qualitätskontrolle |
Warum spezielle Matrix-Hardware wichtig ist
Ein neuronales Netzwerk für das Texture-Sampling auszuführen, wäre zu teuer, wenn jede Multiplikation wie gewöhnliche skalare Shader-Arbeit behandelt werden müsste.
RTXNTC profitiert daher von Cooperative Vector und nun von DirectX 12 Linear Algebra-Pfaden, die Shadern die Nutzung von GPU-Matrixbeschleunigungs-Hardware ermöglichen.
Die Beta v0.10.0 fügte explizit Inferenz über die DirectX 12 Linear Algebra API hinzu, die mit Shader Model 6.10 eingeführt wurde.
Warum neuronale Texturkompression kein Textur-Upscaling ist
Beide Techniken können maschinelles Lernen nutzen, aber sie lösen unterschiedliche Probleme.
Neuronale Texturkompression vs. Super Resolution
| Neuronale Texturkompression | Super Resolution | |
|---|---|---|
| Eingabe | ||
| Ziel | ||
| Wann es läuft | ||
| Ausgabe |
Neuronale Texturkompression kann daher unterhalb von DLSS, FSR, XeSS oder nativem Rendering existieren. Sie ändert, wie Materialdaten gespeichert und rekonstruiert werden, nicht die endgültige Anzeigeauflösung.
Der Qualitätsregler ist Bits pro Pixel
NTC ist verlustbehaftete Kompression. Die Menge der komprimierten Informationen wird weitgehend über die Einstellung Bits pro Pixel gesteuert.
Eine höhere Bitrate gibt dem Modell mehr Informationen und verbessert im Allgemeinen die Rekonstruktionsqualität. Eine niedrigere Bitrate verbessert die Kompression, erhöht aber das Risiko sichtbarer Fehler.
Da mehrere Kanäle dieselbe Repräsentation teilen, kann das Hinzufügen weiterer Materialkanäle ohne Erhöhung der Bitrate die für jeden Kanal verfügbare Qualität verringern.
Warum korrelierte Materialkanäle wichtig sind
Eine neuronale Repräsentation wird wertvoller, wenn mehrere Materialkanäle verwandte Struktur beschreiben.
Wenn Albedo, Normale und Rauheit alle dieselben Kratzer, Nähte oder Gewebestrukturen enthalten, kann der Decoder gemeinsame räumliche Informationen nutzen.
Wenn die Kanäle unzusammenhängendes Rauschen sind, gibt es weniger gemeinsame Struktur zu nutzen und das Kompressionsproblem wird schwieriger.
Der neuronale Texturwert-Test
Wann ist neuronale Texturkompression tatsächlich nützlich?
Warum „8× kleiner“ Kontext braucht
NVIDIAs RTX Kit beschreibt RTX Neural Texture Compression als bis zu 8× Verbesserung des Speicherplatzbedarfs bei ähnlicher visueller Qualität wie traditionelle Blockkompression.
Der Ausdruck „bis zu“ ist wichtig. Das Kompressionsverhältnis hängt vom Material, der Anzahl der Kanäle, der Ziel-Bitrate, der Decoder-Konfiguration und der Qualitätsschwelle ab.
Dasselbe Verhältnis beschreibt auch nicht automatisch VRAM-Einsparungen. Inferenz beim Laden kann von einer kompakten Datei ausgehen und dennoch in konventionelle GPU-Texturen expandieren. Inferenz beim Sampling bewahrt die kompakte Repräsentation im GPU-Speicher, verbraucht aber mehr Rechenleistung während des Shadings.
Die Decoder-Größe ist ein weiterer Kompromiss zwischen Leistung und Qualität
Die NTC-Laufzeit verwendet ein kleines mehrschichtiges Perzeptron, um Texturwerte zu dekodieren.
NVIDIAs aktuelle Bibliothek verwendet eine konfigurierbare Decoder-Architektur. Größere Netzwerke können die Kompressionsqualität verbessern, kosten aber mehr Ausführungszeit; kleinere Netzwerke können schneller laufen, mit einigem Verlust an Rekonstruktionsqualität.
Das gibt Engine-Entwicklern eine weitere Tuning-Dimension jenseits von Texturauflösung und Bitrate.
Warum das für zukünftige Spielinstallationen wichtig ist
Moderne Spiele liefern zunehmend hochauflösende Material-Sets, die sowohl die Download-Größe als auch den Laufzeitspeicher beeinflussen.
Neuronale Texturkompression schafft eine neue Option: eine kompakte gelernte Repräsentation ausliefern und später entscheiden, ob sie beim Laden expandiert, direkt während des Shadings rekonstruiert oder nur angeforderte Kacheln dekodiert wird.
Das bedeutet, dass eine komprimierte Asset-Repräsentation an mehreren verschiedenen Laufzeitspeicher-Strategien teilnehmen kann.
Es ändert auch, was 'Texturspeicher' bedeutet
Beim traditionellen Rendering geht es bei einem Texturspeicher-Budget hauptsächlich um Texturformate, Mip-Ebenen, Auflösung und Residenz.
Bei neuronalen Texturen können Entwickler auch latente Daten, Decoder-Gewichte, Inferenzpuffer, transkodierte Caches und die Berechnungskosten einplanen, die zur Rekonstruktion der angeforderten Werte erforderlich sind.
Das Asset hat also nicht mehr eine einzige einfache feste Speicheridentität.
Herstellerübergreifende Unterstützung ist differenzierter, als der Name RTX vermuten lässt
RTXNTC ist ein NVIDIA-SDK, und die Komprimierung selbst erfordert derzeit laut den SDK-Anforderungen eine NVIDIA-GPU.
Die Laufzeitdekomprimierung ist breiter aufgestellt. NVIDIA dokumentiert funktionale Pfade auf Shader-Model-6-Hardware und vermerkt Validierungen auf NVIDIA-, AMD- und Intel-GPUs, während fortgeschrittene Cooperative-Vector-/Linear-Algebra-Pfade von API- und Treiberunterstützung abhängen.
Leistung und Funktionsparität sollten daher nicht allein deshalb über Hersteller hinweg angenommen werden, weil der grundlegende Decoder ausgeführt werden kann.
Was würde diese Antwort ändern?
NTC befindet sich noch in der Beta-Phase. Laufzeitmodi, Decoder-Architekturen, Treiberunterstützung und Integrationspfade können sich vor einer stabilen Produktionsversion ändern.
Die größte langfristige Veränderung wäre eine breite Einführung standardisierter neuronaler Shader-Primitive über DirectX und Vulkan hinweg. Das würde die neuronale Texturdekodierung weniger abhängig von herstellerspezifischen Ausführungspfaden machen.
Einschränkungen
Dieser Artikel beschreibt die Architektur und das aktuelle öffentliche Verhalten des RTXNTC-SDK. Die von NVIDIA angegebenen Komprimierungsversprechen stammen vom Hersteller und sollten nicht als garantierte Ergebnisse für jedes Material betrachtet werden.
Das aktuelle SDK ist Beta-Software, und einige Vorschau-Pfade haben dokumentierte Treiber- und Plattformbeschränkungen.
Fazit
RTX Neural Texture Compression ist interessant, weil es eine sehr alte Annahme verändert: Texturdetails müssen nicht immer als herkömmliche Texel im Speicher vorliegen.
Ein Material kann stattdessen teilweise als kompakte erlernte Repräsentation gespeichert und bei Bedarf rekonstruiert werden.
Das liefert weder kostenlose Qualität noch kostenlosen Speicher. Es entsteht ein neuer Austausch: weniger Speicher, Bandbreite und potenziell VRAM im Gegenzug für neuronale Inferenzarbeit.
Die eigentliche Innovation ist nicht „KI macht Texturen schärfer“. Sie besteht darin, dass ein Teil der Materialdaten eines Spiels zu Berechnung werden kann.
FAQ
RTX Neural Texture Compression einfach erklärt
Ist RTX Neural Texture Compression ein Upscaler?
Kann NTC den VRAM-Verbrauch reduzieren?
Was speichert das neuronale Netzwerk?
Dekodiert NTC die gesamte Textur vor dem Rendern?
Ist neuronale Texturkompression verlustfrei?
Ist RTXNTC produktionsreif?
Glossar
Wichtige Begriffe der neuronalen Texturierung
- Neural Texture Compression
- Eine Technik, die Texturinformationen als kompakte latente Daten plus neuronale Decoder-Gewichte speichert, anstatt nur konventionelle Texel-Blöcke zu verwenden.
- Latente Daten
- Kompakte erlernte Features, die der neuronale Decoder zur Rekonstruktion der Texturwerte verwendet.
- Decoder
- Ein kleines neuronales Netzwerk, das latente Features in rekonstruierte Texturkanäle umwandelt.
- Inference on Load
- Laufzeitmodus, der die neuronale Textur beim Laden eines Assets dekodiert, üblicherweise in konventionelle Texturformate.
- Inference on Sample
- Laufzeitmodus, der die neuronale Dekodierung direkt während des Texture-Samplings durchführt, sodass die komprimierte Repräsentation resident bleiben kann.
- Inference on Feedback
- Laufzeitstrategie, die Texture-Feedback nutzt, um nur angeforderte Tiles zu dekodieren und zu cachen.
- Texture Storage–Compute Exchange
- Ein Figure-Rocks-Modell, das den Tausch von Texturspeicher, Bandbreite und VRAM gegen zusätzliche neuronale GPU-Inferenzarbeit beschreibt.
- Neural Texture Value Test
- Ein Figure-Rocks-Workflow zur Entscheidung, ob neuronale Texturkompression für ein bestimmtes Material und eine Ziel-GPU einen Nettonutzen bringt.
Primärquellen
NVIDIA Developer — RTX KitOffizielle Übersicht über RTX Neural Texture Compression und NVIDIAs veröffentlichte Positionierung zur Speicherreduzierung.
NVIDIA RTXNTC — SDK READMEOffizielle SDK-Dokumentation, die Materialkanal-Kompression, Decoder-/Latent-Repräsentation, Laufzeitmodi, Speicherbeispiele, Systemanforderungen und Cooperative-Vector-Unterstützung beschreibt.
NVIDIA RTXNTC — ReleasesOffizielle Release-Historie, einschließlich v0.10.0 Beta und DirectX 12 Linear Algebra Inferenz-Unterstützung.
NVIDIA RTXNTC — Kompressionseinstellungen und BildqualitätOffizielle Dokumentation zu Bitrate, Kanalinteraktionen, Qualitätsmessung und verlustbehaftetem Kompressionsverhalten.
NVIDIA — LibNTCOffizielle Laufzeitbibliotheksdokumentation, die Decoder-Konfiguration und den Kompromiss zwischen Qualität und Leistung verschiedener neuronaler Netzwerkgrößen beschreibt.
Related Articles
Speicher-Streaming-Ruckler-Fixes: Wenn Assets nicht hinterherkommen
Streaming-Ruckler treten auf, wenn neue Bereiche geladen werden: Speicher-, Dekompressions- oder Asset-Streaming-Limits. Nutzen Sie diese Fix-Reihenfolge, bevor Sie jede Grafikeinstellung herabsetzen.
Windows Auto SR ist nicht DLSS: Wie NPU-Upscaling ohne Spielintegration funktioniert
Windows Auto SR kann unterstützte Spiele ohne DLSS-, FSR- oder XeSS-Integration hochskalieren. Anstatt das Rekonstruktionsmodell im Spiel auf der GPU auszuführen, verwendet Windows die NPU, um aus einem niedriger aufgelösten Render ein Bild mit höherer Auflösung neu aufzubauen.
Storage und Streaming: Ladezeiten verkürzen, ohne Ruckler zu verursachen
Schneller Speicher hilft nur, wenn das Streaming-Verhalten stabil ist. Dieser Leitfaden erklärt, wie sich IO auf Ruckler auswirkt und was man zuerst ändern sollte.
DLSS 5 ist nicht nur Upscaling: Was 3D-geführtes neuronales Rendering tatsächlich verändert
DLSS 5 verlagert KI in einen neuen Teil der Grafikpipeline. Statt nur die Auflösung zu rekonstruieren oder zusätzliche Frames zu generieren, verwendet 3D-Guided Neural Rendering das eigene Frame der Spiel-Engine als Grundlage und verbessert Beleuchtung und Materialdetails unter Entwicklerkontrolle.
DirectStorage 1.4 lässt deine SSD keine Spiele dekomprimieren: Was Zstd und GPU-Dekompression tatsächlich bewirken
DirectStorage 1.4 fügt Zstandard-Komprimierung, GPU-Dekomprimierung und eine neue Game Asset Conditioning Library hinzu, aber die SSD selbst ist nach wie vor nur ein Teil der Ladepipeline. Dieser Leitfaden erklärt, was die SSD, DirectStorage, CPU, GPU und Game Engine jeweils tatsächlich tun.
Grafikeinstellungen verringert, aber die FPS haben sich nicht verbessert? Wahrscheinlich optimierst du den falschen Engpass
Du reduzierst Schatten, Effekte und Auflösung, aber die FPS ändern sich kaum. Dieser Leitfaden erklärt, warum Grafikoptionen nur dann helfen, wenn sie die Arbeitslast verringern, die tatsächlich die Bildrate begrenzt – und wie man CPU-, GPU-, Speicher-, Streaming- und Frame-Cap-Engpässe erkennt.
VRAM-Nutzung ist nicht VRAM-Anforderung: Warum eine vollständige Speicheranzeige nicht die ganze Geschichte erzählt
Wenn 7,8 GB auf einer 8-GB-Grafikkarte belegt sind, kann das wie ein Beweis dafür aussehen, dass einem Spiel der VRAM ausgegangen ist. So einfach ist es nicht. Dieser Leitfaden erklärt VRAM-Kapazität, Residenzbudgets, Working Sets, Shared Memory und wie man feststellt, ob Speicherdruck tatsächlich Ruckeln verursacht.
amiibo FAQ: Die 20 Fragen, die jeder stellt (und die direkten Antworten)
Ein schnörkelloses Amiibo-FAQ: Kompatibilität, Scannen, Regionen, Neuauflagen, Wert und Sammelregeln — klar beantwortet, damit Anfänger aufhören, Geld zu verschwenden.